Exercise 4 — VAE
Neste exercício treinei um VAE no MNIST. No Exercise 1 o espaço latente tem \(d = 16\) dimensões, e acompanho os dois termos da perda separadamente. No Exercise 2 o mesmo modelo tem \(d = 2\), o que permite desenhar o espaço latente e medir o custo dessa redução.
Como fiz.
- O VAE está em
code/vae.py: encoder, as duas cabeças (\(\boldsymbol{\mu}\) e \(\log \boldsymbol{\sigma}^2\)) e decoder com a arquitetura do enunciado. O autograd do PyTorch calcula os gradientes. A reparametrização, os dois termos da perda e a amostragem da prior foram escritos à mão, sem classe de VAE pronta e semtorch.distributions. - Todos os valores estão em nats por imagem: soma nos 784 pixels (ou nas \(d\) dimensões) e média nas imagens.
- Treino com Adam (\(10^{-3}\)), lote 128 e 20 épocas. Chamo
torch.manual_seed(42)antes de construir cada modelo. A validação é medida ao fim de cada época. O teste só é usado depois do treino, para os números finais. - Na validação e no teste, \(z\) é sorteado de \(q(z \mid x)\), uma amostra por imagem. Esse sorteio usa um gerador próprio com seed fixa, para que medir a validação não altere o treino.
- Em algumas análises usei um classificador de dígitos auxiliar (
code/digit_judge.py): uma rede 784 → 256 → 10 treinada no conjunto de treino, com 96.89% de acurácia na validação. Ele não faz parte do VAE. Uso a confiança dele para medir se uma imagem gerada é reconhecível como dígito, como no laboratório da Aula 17. - Fixei
torch.set_num_threads(4). Rodei os scripts do zero mais de uma vez, em pastas diferentes, e também o notebook. Os números foram iguais em todas as execuções. Cada treino de 20 épocas levou cerca de 3.5 minutos.
O notebook com todas as saídas está em code/vae_notebook.ipynb.
"""VAE para o MNIST: dados, modelo, perda e treino. Usado pelos Exercises 1 e 2.

O autograd do PyTorch calcula os gradientes. A reparametrização, os dois termos da perda e a
amostragem estão escritos aqui à mão: não uso classe de VAE de biblioteca nem torch.distributions.
"""
from pathlib import Path

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, TensorDataset, random_split
from torchvision import datasets, transforms

DATA = Path(__file__).resolve().parent / "data"     # o MNIST é baixado aqui na primeira execução
DATA.mkdir(exist_ok=True)
LR, BATCH, EPOCHS, BETA = 1e-3, 128, 20, 1.0        # Adam 1e-3, lote 128, 20 épocas, beta = 1


# ---------------------------------------------------------------- dados
def load_mnist():
    """Treino 50 000 e validação 10 000 (split do enunciado) e o teste oficial de 10 000.

    Devolve (X_train, y_train, X_val, y_val, X_test, y_test), com X em tensores (N, 784) e pixels em [0, 1].
    """
    train_full = datasets.MNIST(DATA, train=True, download=True, transform=transforms.ToTensor())
    test = datasets.MNIST(DATA, train=False, download=True, transform=transforms.ToTensor())
    train, val = random_split(train_full, [50_000, 10_000],
                              generator=torch.Generator().manual_seed(42))

    def to_tensors(dataset, indices):
        # ToTensor() divide o uint8 por 255. Aplico a mesma conta de uma vez nas imagens escolhidas
        # pelo split, em vez de converter imagem por imagem (o resultado é o mesmo, só mais rápido).
        X = dataset.data[indices].reshape(-1, 784).float() / 255.0
        return X, dataset.targets[indices]

    X_train, y_train = to_tensors(train_full, torch.tensor(train.indices))
    X_val, y_val = to_tensors(train_full, torch.tensor(val.indices))
    X_test, y_test = to_tensors(test, torch.arange(len(test)))
    assert torch.equal(X_train[0], train[0][0].reshape(784))      # confere: igual ao ToTensor() do split
    assert torch.equal(X_val[0], val[0][0].reshape(784))
    return X_train, y_train, X_val, y_val, X_test, y_test


# ---------------------------------------------------------------- modelo
class VAE(nn.Module):
    """Encoder 784 -> 512 -> 256 (ReLU), cabeças mu e log sigma^2 (256 -> d), decoder d -> 256 -> 512 -> 784."""

    def __init__(self, d):
        super().__init__()
        self.d = d
        self.encoder = nn.Sequential(nn.Linear(784, 512), nn.ReLU(),
                                     nn.Linear(512, 256), nn.ReLU())
        self.mu_head = nn.Linear(256, d)
        self.logvar_head = nn.Linear(256, d)          # a rede prevê log sigma^2, que pode ser qualquer real
        self.decoder = nn.Sequential(nn.Linear(d, 256), nn.ReLU(),
                                     nn.Linear(256, 512), nn.ReLU(),
                                     nn.Linear(512, 784), nn.Sigmoid())   # cada pixel vira uma probabilidade

    def encode(self, x):
        h = self.encoder(x)
        return self.mu_head(h), self.logvar_head(h)

    def reparameterize(self, mu, logvar, generator=None):
        """Truque da reparametrização: z = mu + sigma * eps, com eps ~ N(0, I).

        O sorteio fica todo em eps, que não depende dos parâmetros. Assim z é uma função
        diferenciável de mu e sigma, e o gradiente chega no encoder.
        """
        sigma = torch.exp(0.5 * logvar)               # sigma = exp(log sigma^2 / 2)
        eps = torch.randn(sigma.shape, generator=generator)
        return mu + sigma * eps

    def decode(self, z):
        return self.decoder(z)

    def forward(self, x, generator=None):
        mu, logvar = self.encode(x)
        z = self.reparameterize(mu, logvar, generator)
        return self.decode(z), mu, logvar

    @torch.no_grad()
    def sample(self, n):
        """Amostra do modelo: z ~ N(0, I) (a prior) e decodifica. Usa o gerador global do torch."""
        z = torch.randn(n, self.d)
        return self.decode(z)


# ---------------------------------------------------------------- perda
def loss_terms(x, x_hat, mu, logvar):
    """Os dois termos da perda em nats por imagem: soma nos 784 pixels (ou nas d dimensões), média nas imagens.

    Reconstrução: BCE somada nos pixels = -log p(x|z) com cada pixel Bernoulli.
    KL: forma fechada de KL(N(mu, sigma^2) || N(0, I)) = 1/2 * sum(mu^2 + sigma^2 - 1 - log sigma^2).
    """
    n = x.shape[0]
    recon = F.binary_cross_entropy(x_hat, x, reduction="sum") / n     # "sum" e não "mean" (ver o relatório)
    kl = 0.5 * torch.sum(mu.pow(2) + logvar.exp() - 1.0 - logvar) / n
    return recon, kl


@torch.no_grad()
def evaluate(model, X, use_mean=False, seed=0):
    """Reconstrução e KL médios por imagem em X, com o modelo em modo de avaliação.

    Por padrão z é sorteado de q(z|x) (uma amostra por imagem), que é a estimativa usual do ELBO.
    O sorteio usa um gerador próprio com seed fixa, então avaliar não mexe na sequência aleatória do treino.
    Com use_mean=True o decoder recebe mu em vez de um z sorteado.
    """
    model.eval()
    gen = torch.Generator().manual_seed(seed)
    total_recon = total_kl = 0.0
    for i in range(0, len(X), 1000):
        x = X[i:i + 1000]
        mu, logvar = model.encode(x)
        z = mu if use_mean else model.reparameterize(mu, logvar, gen)
        recon, kl = loss_terms(x, model.decode(z), mu, logvar)
        total_recon += recon.item() * len(x)
        total_kl += kl.item() * len(x)
    return total_recon / len(X), total_kl / len(X)


# ---------------------------------------------------------------- treino
def train_vae(d, X_train, X_val, epochs=EPOCHS, verbose=True):
    """Treina um VAE com latente de dimensão d. Devolve o modelo e o histórico dos dois termos por época."""
    torch.manual_seed(42)                             # seed fixada antes de construir cada modelo
    model = VAE(d)
    opt = torch.optim.Adam(model.parameters(), lr=LR)
    loader = DataLoader(TensorDataset(X_train), batch_size=BATCH, shuffle=True)
    history = {"train_recon": [], "train_kl": [], "val_recon": [], "val_kl": []}
    history["init_recon"], history["init_kl"] = evaluate(model, X_val)   # validação antes da 1ª época

    for epoch in range(1, epochs + 1):
        model.train()
        sum_recon = sum_kl = 0.0
        for (x,) in loader:
            x_hat, mu, logvar = model(x)
            recon, kl = loss_terms(x, x_hat, mu, logvar)
            loss = recon + BETA * kl                  # -ELBO por imagem
            opt.zero_grad()
            loss.backward()
            opt.step()
            sum_recon += recon.item() * len(x)        # média da época ponderada pelo tamanho do lote
            sum_kl += kl.item() * len(x)
        history["train_recon"].append(sum_recon / len(X_train))
        history["train_kl"].append(sum_kl / len(X_train))
        val_recon, val_kl = evaluate(model, X_val)    # validação ao fim de cada época
        history["val_recon"].append(val_recon)
        history["val_kl"].append(val_kl)
        if verbose:
            print(f"   época {epoch:2d}: treino rec {history['train_recon'][-1]:7.2f}  KL {history['train_kl'][-1]:5.2f}"
                  f" | validação rec {val_recon:7.2f}  KL {val_kl:5.2f}")
    return model, history


def load_or_train(d, X_train, X_val):
    """Carrega o modelo salvo pelo Exercise 1 (se existir) ou treina de novo com a mesma seed."""
    path = DATA / f"vae_d{d}.pt"
    if path.exists():
        torch.manual_seed(42)
        model = VAE(d)
        model.load_state_dict(torch.load(path))
        model.eval()
        return model
    model, _ = train_vae(d, X_train, X_val, verbose=False)
    torch.save(model.state_dict(), path)
    return model
"""Classificador de dígitos auxiliar, usado só nas análises. Não faz parte do VAE.

Uma rede simples (784 -> 256 -> 10) treinada no conjunto de treino. Serve de "juiz" para dizer se uma
imagem gerada parece um dígito, e qual: a confiança é a maior probabilidade da softmax.
"""
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, TensorDataset


def train_judge(X_train, y_train, epochs=5):
    torch.manual_seed(42)
    clf = nn.Sequential(nn.Linear(784, 256), nn.ReLU(), nn.Linear(256, 10))
    opt = torch.optim.Adam(clf.parameters(), lr=1e-3)
    for _ in range(epochs):
        for x, y in DataLoader(TensorDataset(X_train, y_train), batch_size=128, shuffle=True):
            loss = F.cross_entropy(clf(x), y)
            opt.zero_grad(); loss.backward(); opt.step()
    clf.eval()

    @torch.no_grad()
    def judge(imgs):
        """Dígito previsto e confiança para cada imagem (N, 784)."""
        p = F.softmax(clf(imgs), dim=1)
        confidence, label = p.max(1)
        return label.numpy(), confidence.numpy()

    return judge
Exercise 1
A VAE on MNIST. Script do exercício:
"""Exercise 1 — VAE com d = 16 no MNIST.

Gera figures/fig1.png, fig2.png e fig3.png e imprime os números do relatório.
Salva o modelo treinado em code/data/vae_d16.pt, que o Exercise 2 usa na interpolação.
Roda de qualquer diretório: python ex1_mnist.py
"""
import time
from pathlib import Path

import numpy as np
import torch
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

from digit_judge import train_judge
from vae import DATA, EPOCHS, VAE, evaluate, load_mnist, train_vae

FIG = Path(__file__).resolve().parent.parent / "figures"
FIG.mkdir(exist_ok=True)
torch.set_num_threads(4)                     # fixa o número de threads para o resultado não variar entre máquinas

# ---------------------------------------------------------------- A — dados
X_train, y_train, X_val, y_val, X_test, y_test = load_mnist()
print(f"A) treino {tuple(X_train.shape)}, validação {tuple(X_val.shape)}, teste {tuple(X_test.shape)}; "
      f"pixels em [{X_train.min():.0f}, {X_train.max():.0f}]")

# ---------------------------------------------------------------- B — modelo
D = 16
print(f"B) {VAE(D)}")
print(f"   parâmetros: {sum(p.numel() for p in VAE(D).parameters())}")

# ---------------------------------------------------------------- C — treino
t0 = time.time()
model, hist = train_vae(D, X_train, X_val)
print(f"C) treino de {EPOCHS} épocas em {time.time() - t0:.0f} s")
torch.save(model.state_dict(), DATA / "vae_d16.pt")

# O teste só é usado aqui, depois do treino, para os números finais
test_recon, test_kl = evaluate(model, X_test)
print(f"C) teste: reconstrução {test_recon:.2f}, KL {test_kl:.2f}, -ELBO {test_recon + test_kl:.2f} nats por imagem")
print(f"   validação: KL na época 1 = {hist['val_kl'][0]:.2f}, na época {EPOCHS} = {hist['val_kl'][-1]:.2f}")

epochs = np.arange(1, EPOCHS + 1)
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
for ax, term, label in [(axes[0], "recon", "reconstrução (BCE)"), (axes[1], "kl", "KL")]:
    ax.plot(epochs, hist[f"train_{term}"], "o-", ms=3, label="treino (média da época)")
    ax.plot(epochs, hist[f"val_{term}"], "s-", ms=3, label="validação (fim da época)")
    ax.set_xlabel("época"); ax.set_ylabel("nats por imagem")
    ax.set_title(label); ax.set_xticks(epochs[::2]); ax.legend()
fig.suptitle(f"Figure 1 — Exercise 1: os dois termos da perda por época (d = {D})")
fig.tight_layout()
fig.savefig(FIG / "fig1.png", bbox_inches="tight"); plt.close(fig)

# ---------------------------------------------------------------- D — reconstruções e amostras
model.eval()
first_idx = [int((y_test == k).nonzero()[0]) for k in range(10)]    # primeira imagem de teste de cada dígito
x10 = X_test[first_idx]
with torch.no_grad():
    mu10, _ = model.encode(x10)
    rec10 = model.decode(mu10)                                       # reconstrução a partir de mu, sem sortear z
print(f"D) índices de teste da Figure 2 (dígitos 0 a 9): {first_idx}")

fig, axes = plt.subplots(2, 10, figsize=(12, 2.9))
for k in range(10):
    for row, imgs in enumerate([x10, rec10]):
        axes[row, k].imshow(imgs[k].reshape(28, 28), cmap="gray", vmin=0, vmax=1)
        axes[row, k].set_xticks([]); axes[row, k].set_yticks([])
    axes[0, k].set_title(f"dígito {k}", fontsize=9)
axes[0, 0].set_ylabel("original"); axes[1, 0].set_ylabel("reconstrução\n(decodifica μ)")
fig.supxlabel("dígito (primeira imagem de teste de cada um)", y=-0.02)
fig.suptitle("Figure 2 — Exercise 1: primeira imagem de teste de cada dígito e sua reconstrução (d = 16)")
fig.savefig(FIG / "fig2.png", bbox_inches="tight"); plt.close(fig)

torch.manual_seed(0)
samples = model.sample(64)                                           # z ~ N(0, I), depois o decoder
grid = samples.reshape(8, 8, 28, 28).permute(0, 2, 1, 3).reshape(8 * 28, 8 * 28)
fig, ax = plt.subplots(figsize=(6, 6.3))
ax.imshow(grid, cmap="gray", vmin=0, vmax=1)
ax.set_xticks(np.arange(8) * 28 + 13.5); ax.set_xticklabels(range(1, 9))
ax.set_yticks(np.arange(8) * 28 + 13.5); ax.set_yticklabels(range(1, 9))
ax.set_xlabel("coluna da grade"); ax.set_ylabel("linha da grade")
ax.set_title("Figure 3 — Exercise 1: 64 amostras de z ~ N(0, I)\ndecodificadas (d = 16, torch.manual_seed(0))")
fig.savefig(FIG / "fig3.png", bbox_inches="tight"); plt.close(fig)

# ---------------------------------------------------------------- E — números para a análise (validação)
# 1) KL subindo no começo: quanto a reconstrução caiu enquanto o KL subia
print(f"E1) validação antes do treino: reconstrução {hist['init_recon']:.2f}, KL {hist['init_kl']:.2f}")
print(f"    KL de validação por época: {np.round(hist['val_kl'], 2).tolist()}")
print(f"    reconstrução de validação por época: {np.round(hist['val_recon'], 2).tolist()}")
k = int(np.argmax(np.diff(hist["val_kl"]) < 0))          # última época da subida inicial do KL (índice)
r0, r1 = hist["init_recon"], hist["val_recon"][k]
k0, k1 = hist["init_kl"], hist["val_kl"][k]
print(f"    do início à época {k + 1} (fim da subida contínua): KL {k0:.2f} -> {k1:.2f} ({k1 - k0:+.2f}), "
      f"reconstrução {r0:.2f} -> {r1:.2f} ({r1 - r0:+.2f}), total {r0 + k0:.2f} -> {r1 + k1:.2f}")
print(f"    da época 1 à época {k + 1}: KL {hist['val_kl'][0]:.2f} -> {k1:.2f} ({k1 - hist['val_kl'][0]:+.2f}), "
      f"reconstrução {hist['val_recon'][0]:.2f} -> {r1:.2f} ({r1 - hist['val_recon'][0]:+.2f})")

with torch.no_grad():
    mu_v, logvar_v = model.encode(X_val)
kl_dim = 0.5 * (mu_v.pow(2) + logvar_v.exp() - 1 - logvar_v).mean(0)  # KL médio por dimensão latente
print(f"E2) KL médio por dimensão (validação): {np.round(kl_dim.numpy(), 2).tolist()}")
active = kl_dim >= 0.1
print(f"    dimensões ativas (KL >= 0.1 nat): {active.sum().item()} de {D}")

# 2) Onde as amostras da prior caem: distância até o código mu de imagem real mais próximo, só nas
#    dimensões ativas. Referência: mu das 5 000 primeiras imagens de validação. Para comparar, faço a mesma
#    conta com códigos z ~ q(z|x) de outras 5 000 imagens de validação (que não estão na referência).
ref = mu_v[:5000, active]
gen = torch.Generator().manual_seed(1)
with torch.no_grad():
    z_post = model.reparameterize(mu_v[5000:], logvar_v[5000:], gen)   # códigos de imagens reais
    torch.manual_seed(0)
    z_prior = torch.randn(64, D)                                       # os mesmos z da Figure 3
d_post = torch.cdist(z_post[:, active], ref).min(1).values
d_prior = torch.cdist(z_prior[:, active], ref).min(1).values
thr = torch.quantile(d_post, 0.95)
far = d_prior > thr                                                    # amostras "longe" de qualquer imagem real
print(f"E2) distância mediana até o mu real mais próximo: códigos de imagens reais {d_post.median():.2f}, "
      f"amostras da prior {d_prior.median():.2f}")
print(f"    amostras da Figure 3 acima do quantil 95% dos códigos reais ({thr:.2f}): {far.sum().item()} de 64")

# 3) O decoder devolve probabilidades: fração de pixels "cinza" (entre 0.1 e 0.9)
gray = lambda imgs: ((imgs > 0.1) & (imgs < 0.9)).float().mean().item() * 100
print(f"E2) pixels entre 0.1 e 0.9: originais da Figure 2 {gray(x10):.1f}%, reconstruções {gray(rec10):.1f}%, "
      f"amostras da Figure 3 {gray(samples):.1f}%")
print(f"    nas amostras da Figure 3: {gray(samples[far]):.1f}% nas {far.sum().item()} longe, "
      f"{gray(samples[~far]):.1f}% nas outras {(~far).sum().item()}")
far_cells = [(i // 8 + 1, i % 8 + 1) for i in far.nonzero().flatten().tolist()]
print(f"    posições (linha, coluna) das amostras longe: {far_cells}")

# 3b) Parece um dígito? Confiança do classificador auxiliar (digit_judge.py)
judge = train_judge(X_train, y_train)
_, c_rec = judge(rec10)
_, c_smp = judge(samples)
f = far.numpy()
print(f"    confiança média do classificador: reconstruções da Figure 2 {c_rec.mean():.2f}, "
      f"amostras da Figure 3 {c_smp.mean():.2f} (longe {c_smp[f].mean():.2f}, outras {c_smp[~f].mean():.2f})")
print(f"    amostras da Figure 3 com confiança < 0.6: {(c_smp < 0.6).sum()} de 64 ({(c_smp[f] < 0.6).sum()} delas longe)")

# 4) Decodificar mu ou um z sorteado
rec_mu = evaluate(model, X_val, use_mean=True)[0]
rec_z = evaluate(model, X_val)[0]
print(f"E3) reconstrução de validação decodificando mu {rec_mu:.2f} vs z sorteado {rec_z:.2f} nats por imagem")
print(f"    sigma médio no encoder: {torch.exp(0.5 * logvar_v).mean():.3f}; |mu| médio: {mu_v.abs().mean():.3f}")
A — Load and split the data
Carreguei o MNIST do torchvision com transforms.ToTensor() e fiz o random_split como no enunciado: 50 000 imagens de treino e 10 000 de validação, com torch.Generator().manual_seed(42). As 10 000 imagens oficiais de teste formam o conjunto de teste. Cada imagem vira um vetor de 784 pixels em \([0, 1]\).
Para não converter as imagens a cada época, guardo os três conjuntos como tensores. Uso os índices escolhidos pelo random_split e divido o uint8 por 255, que é a conta do ToTensor(). O código confere que o resultado é igual ao do ToTensor().
B — Build the model
| parte | camadas |
|---|---|
| encoder | \(784 \to 512 \to 256\), ReLU depois de cada uma |
| cabeças | duas lineares \(256 \to 16\): uma para \(\boldsymbol{\mu}\), outra para \(\log \boldsymbol{\sigma}^2\) |
| decoder | \(16 \to 256 \to 512 \to 784\), ReLU nas ocultas e sigmoide na saída |
O modelo tem 1 079 600 parâmetros. As partes específicas do VAE, em vae.py:
- Reparametrização: \(\mathbf{z} = \boldsymbol{\mu} + \boldsymbol{\sigma} \odot \boldsymbol{\varepsilon}\), com \(\boldsymbol{\varepsilon} \sim \mathcal{N}(0, I)\) e \(\boldsymbol{\sigma} = \exp(\tfrac12 \log \boldsymbol{\sigma}^2)\). O sorteio fica em \(\boldsymbol{\varepsilon}\), que não depende dos parâmetros. Assim o gradiente passa por \(\boldsymbol{\mu}\) e \(\boldsymbol{\sigma}\) até o encoder.
- Reconstrução: BCE somada nos 784 pixels, que é \(-\log p(\mathbf{x} \mid \mathbf{z})\) com cada pixel Bernoulli. Uso
F.binary_cross_entropy(..., reduction="sum")e divido pelo tamanho do lote. Comreduction="mean"a BCE seria dividida também por 784, o que equivale a \(\beta \approx 784\). - KL em forma fechada: \(\tfrac12 \sum_{i=1}^{d} (\mu_i^2 + \sigma_i^2 - 1 - \log \sigma_i^2)\).
- Perda: reconstrução \(+\ \beta \cdot\) KL, com \(\beta = 1\), na média das imagens do lote.
- Amostragem: \(\mathbf{z} \sim \mathcal{N}(0, I)\) com
torch.randn, seguido do decoder.
C — Train
Treinei 20 épocas com Adam (\(10^{-3}\)) e lote 128, registrando os dois termos no treino (média da época) e na validação (fim da época).
Resultado no teste: reconstrução 81.77, KL 19.94 e \(-\)ELBO 101.72 nats por imagem, próximo da referência do enunciado (cerca de 81 e 20). Na validação, o KL foi 13.44 na primeira época e 19.88 na última, e a reconstrução foi de 129.94 para 82.39.
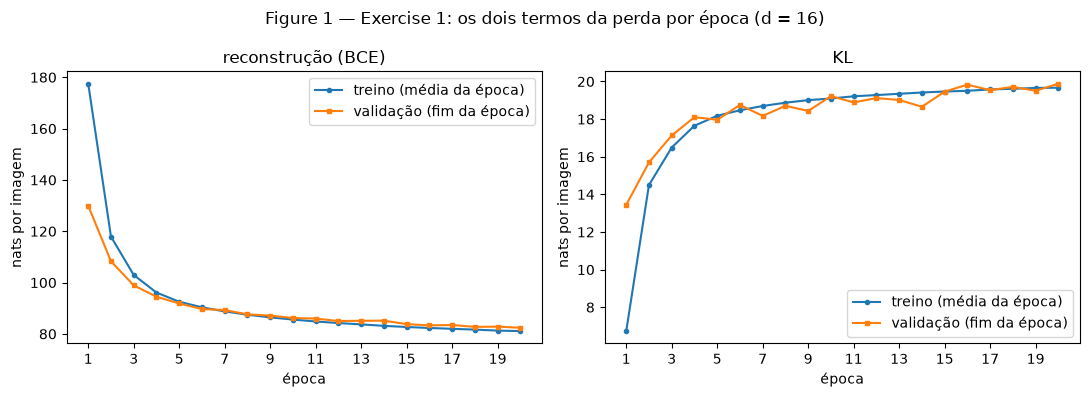
Na primeira época, a curva de treino fica acima da de validação na reconstrução (177.50 contra 129.94) e abaixo no KL (6.73 contra 13.44). Isso ocorre porque o valor de treino é a média da época, que inclui o início do treino, e a validação é medida no fim da época. A partir da época 5 as curvas ficam próximas. Na época 20 a reconstrução foi 81.09 no treino e 82.39 na validação, então não há sinal de overfitting.
D — Reconstructions and samples
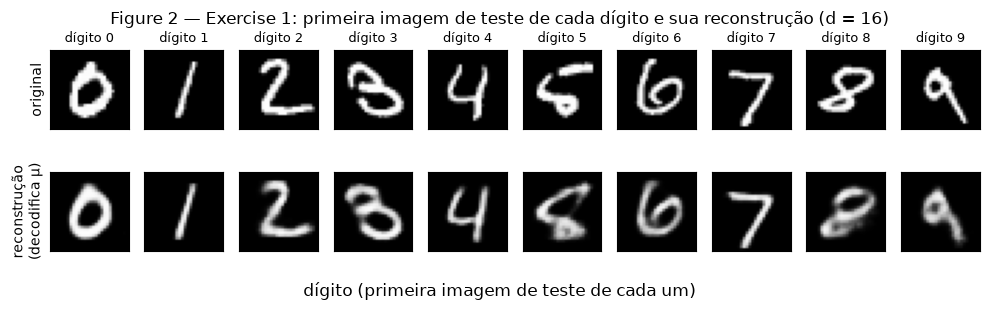
Linha de cima: a primeira imagem de teste de cada dígito (índices 3, 2, 1, 18, 4, 8, 11, 0, 61 e 7, para os dígitos de 0 a 9). Linha de baixo: a reconstrução decodificando \(\boldsymbol{\mu}\), sem sortear \(z\).
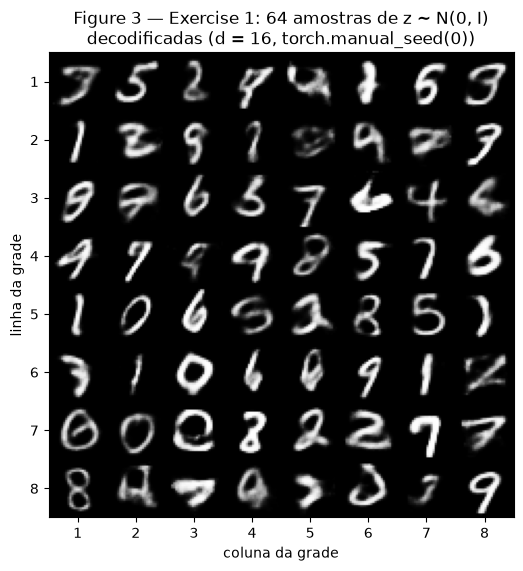
A Figure 3 tem 64 imagens decodificadas de \(\mathbf{z} \sim \mathcal{N}(0, I)\), sorteadas depois de torch.manual_seed(0).
E — Analysis
Por que o KL sobe no começo enquanto a perda total cai? Antes do treino, o KL de validação era 0.03 e a reconstrução era 544.71. Com os pesos iniciais, \(\boldsymbol{\mu} \approx 0\) e \(\boldsymbol{\sigma} \approx 1\), então \(q(z \mid x)\) é quase igual à prior para qualquer imagem. Nesse caso \(z\) não contém informação sobre a imagem, e o decoder não consegue reconstruí-la. Para reduzir a reconstrução, o encoder precisa afastar \(\boldsymbol{\mu}\) de zero e reduzir \(\boldsymbol{\sigma}\), o que aumenta o KL. No início, a queda da reconstrução é muito maior que o aumento do KL:
- do início até a época 4, o KL subiu 18.07 nats (de 0.03 para 18.10) e a reconstrução caiu 450.22 (de 544.71 para 94.49);
- da época 1 para a época 4, o KL subiu 4.66 e a reconstrução caiu 35.45, cerca de 7.6 nats de reconstrução para cada nat de KL.
Como o otimizador minimiza a soma dos dois termos, aumentar o KL reduz a perda total. Depois da época 4 o KL quase não sobe (de 18.10 para 19.88 em 16 épocas), enquanto a reconstrução ainda cai 12.10 nats.
Por que a Figure 3 é pior que a Figure 2?
- Onde as amostras da prior caem. Na Figure 2, \(z\) é o \(\boldsymbol{\mu}\) de uma imagem real e está numa região em que o decoder foi treinado. Na Figure 3, \(z\) vem de \(\mathcal{N}(0, I)\), e o KL não garante que os códigos das imagens reais cubram toda a prior. Ficam regiões sem códigos de imagens reais, os "buracos" do espaço latente da Aula 17, onde o decoder não foi treinado. Para medir isso, usei as 11 dimensões ativas (as outras 5 têm KL praticamente zero e não carregam informação) e calculei a distância de cada ponto até o \(\boldsymbol{\mu}\) mais próximo de 5 000 imagens de validação. Para códigos de outras 5 000 imagens de validação, a distância mediana foi 1.47. Para as 64 amostras da Figure 3, foi 1.83. 23 das 64 amostras ficaram acima do quantil de 95% dos códigos reais (seriam cerca de 3 se as amostras caíssem onde caem os códigos reais). O classificador auxiliar confia menos nessas amostras: confiança média de 0.73 nelas e 0.85 nas outras 41, contra 0.91 nas reconstruções da Figure 2.
- O que o decoder devolve para um \(z\). O decoder devolve a probabilidade de cada pixel estar aceso, e a saída que minimiza a perda é a média das imagens compatíveis com aquele \(z\) (Aula 17). Uma média de imagens é borrada. A fração de pixels cinza (entre 0.1 e 0.9) é 9.2% nas imagens originais da Figure 2, 17.8% nas reconstruções e 16.5% nas amostras da Figure 3. O borrão, portanto, aparece nas duas figuras. A diferença está em quais imagens são compatíveis com \(z\). O \(\boldsymbol{\mu}\) de uma imagem real corresponde a imagens parecidas com ela, e a média continua sendo aquele dígito. Um \(z\) da prior entre códigos de dígitos diferentes é compatível com imagens de vários dígitos, e a média mistura os traços deles, como nas posições (2, 2) e (8, 2) da Figure 3. Por isso aparecem formas que não são dígitos, mesmo sem mais pixels cinza.
Por que decodificar \(\boldsymbol{\mu}\) e não um \(z\) sorteado na Figure 2? \(\boldsymbol{\mu}\) é o centro de \(q(z \mid x)\), o código mais provável da imagem. Um \(z\) sorteado é \(\boldsymbol{\mu}\) mais um ruído de desvio \(\boldsymbol{\sigma}\), e esse ruído é grande: na validação, o \(\sigma\) médio foi 0.440 e o \(|\mu|\) médio foi 0.555. Com \(z\) sorteado, cada execução daria uma reconstrução diferente, e a figura mostraria o ruído do sorteio além da qualidade do modelo. Com \(\boldsymbol{\mu}\) a reconstrução é determinística e melhor: 77.42 nats na validação, contra 82.39 com \(z\) sorteado.
Exercise 2
A Latent Space You Can See. Script do exercício:
"""Exercise 2 — o mesmo VAE com d = 2, um espaço latente que dá para desenhar.

Gera figures/fig4.png, fig5.png e fig6.png e imprime os números do relatório.
A interpolação latente usa o modelo d = 16 salvo pelo Exercise 1 (se ele não existir, é treinado de novo
com a mesma seed). Roda de qualquer diretório: python ex2_latent2d.py
"""
from pathlib import Path

import numpy as np
import torch
from scipy.stats import norm
from sklearn.neighbors import KNeighborsClassifier
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

from digit_judge import train_judge
from vae import DATA, EPOCHS, evaluate, load_mnist, load_or_train, train_vae

FIG = Path(__file__).resolve().parent.parent / "figures"
FIG.mkdir(exist_ok=True)
torch.set_num_threads(4)                     # o mesmo número de threads do Exercise 1

X_train, y_train, X_val, y_val, X_test, y_test = load_mnist()

# ---------------------------------------------------------------- A — VAE com d = 2
# Mesmo modelo, dados, seed, beta e orçamento do Exercise 1. Só muda d.
model2, hist2 = train_vae(2, X_train, X_val)
torch.save(model2.state_dict(), DATA / "vae_d2.pt")
model16 = load_or_train(16, X_train, X_val)
model2.eval(); model16.eval()

rec2, kl2 = evaluate(model2, X_test)         # teste só para os números finais
rec16, kl16 = evaluate(model16, X_test)
print("A) teste, nats por imagem:")
print(f"   d = 16: reconstrução {rec16:.2f}, KL {kl16:.2f}, -ELBO {rec16 + kl16:.2f}")
print(f"   d =  2: reconstrução {rec2:.2f}, KL {kl2:.2f}, -ELBO {rec2 + kl2:.2f}")
print(f"   diferença (d=2 - d=16): reconstrução {rec2 - rec16:+.2f}, KL {kl2 - kl16:+.2f}, -ELBO {rec2 + kl2 - rec16 - kl16:+.2f}")
print(f"   d = 2, validação: KL na época 1 = {hist2['val_kl'][0]:.2f}, na época {EPOCHS} = {hist2['val_kl'][-1]:.2f}; "
      f"reconstrução na época {EPOCHS} = {hist2['val_recon'][-1]:.2f}")

# ---------------------------------------------------------------- B — o teste codificado
with torch.no_grad():
    mu_test = model2.encode(X_test)[0].numpy()
    mu_train = model2.encode(X_train)[0].numpy()

colors = plt.cm.tab10(np.arange(10))
order = np.random.default_rng(0).permutation(len(mu_test))   # ordem aleatória: nenhum dígito fica escondido por baixo
fig, ax = plt.subplots(figsize=(8, 7))
ax.scatter(mu_test[order, 0], mu_test[order, 1], s=3, alpha=0.6, color=colors[y_test.numpy()[order]])
for k in range(10):                                           # pontos vazios só para montar a legenda
    ax.scatter([], [], s=12, color=colors[k], label=f"{k}")
lim = norm.ppf(0.95)
ax.add_patch(plt.Rectangle((-lim, -lim), 2 * lim, 2 * lim, fill=False, ls="--", color="black",
                           label="área da Figure 5"))
ax.set_xlabel("$\\mu_1$"); ax.set_ylabel("$\\mu_2$")
ax.set_title("Figure 4 — Exercise 2: μ das 10 000 imagens de teste (d = 2), cor = dígito")
ax.legend(title="dígito", markerscale=1.5, loc="center left", bbox_to_anchor=(1.01, 0.5))
fig.savefig(FIG / "fig4.png", bbox_inches="tight"); plt.close(fig)

# Sobreposição medida: um k-vizinhos no plano latente, ajustado com o treino e aplicado no teste.
# Os pares que ele mais confunde são os dígitos que se misturam na Figure 4.
knn = KNeighborsClassifier(n_neighbors=15).fit(mu_train, y_train.numpy())
pred = knn.predict(mu_test)
print(f"B) acurácia de um 15-vizinhos no plano latente (teste): {(pred == y_test.numpy()).mean():.4f}")
conf = np.zeros((10, 10), int)
np.add.at(conf, (y_test.numpy(), pred), 1)
pairs = sorted(((conf[i, j] + conf[j, i], i, j) for i in range(10) for j in range(i + 1, 10)), reverse=True)
print("   pares mais confundidos (erros nos dois sentidos):", [(f"{i}-{j}", n) for n, i, j in pairs[:6]])
centers = np.array([np.median(mu_test[y_test.numpy() == k], axis=0) for k in range(10)])
print("   mediana de μ por dígito:", {k: centers[k].round(2).tolist() for k in range(10)})

# ---------------------------------------------------------------- juiz auxiliar para as análises
# Classificador de dígitos de digit_judge.py: diz "isto parece o dígito k" nas imagens geradas.
judge = train_judge(X_train, y_train)
print(f"   classificador auxiliar: acurácia na validação {(judge(X_val)[0] == y_val.numpy()).mean():.4f}")

# ---------------------------------------------------------------- C — o plano decodificado
q = np.linspace(0.05, 0.95, 15)
zs = norm.ppf(q)                             # quantis da N(0, 1): cada faixa tem a mesma massa da prior
print(f"C) valores de z na grade: {zs.round(2).tolist()}")
Z1, Z2 = np.meshgrid(zs, zs[::-1])           # linha de cima = z2 maior, como no gráfico da Figure 4
grid_z = torch.tensor(np.stack([Z1.ravel(), Z2.ravel()], 1), dtype=torch.float32)
with torch.no_grad():
    grid_img = model2.decode(grid_z)
tile = grid_img.reshape(15, 15, 28, 28).permute(0, 2, 1, 3).reshape(15 * 28, 15 * 28)

fig, ax = plt.subplots(figsize=(9, 9.3))
ax.imshow(tile, cmap="gray", vmin=0, vmax=1)
ticks = np.arange(15) * 28 + 13.5
ax.set_xticks(ticks); ax.set_xticklabels([f"{v:.2f}" for v in zs], rotation=90)
ax.set_yticks(ticks); ax.set_yticklabels([f"{v:.2f}" for v in zs[::-1]])
ax.set_xlabel("$z_1 = \\Phi^{-1}(q)$"); ax.set_ylabel("$z_2 = \\Phi^{-1}(q)$")
ax.set_title("Figure 5 — Exercise 2: decoder de d = 2 numa grade 15×15\nnos quantis q = 0.05, ..., 0.95 da N(0, 1)")
fig.savefig(FIG / "fig5.png", bbox_inches="tight"); plt.close(fig)

lab_grid, conf_grid = judge(grid_img)
print("   dígito que o classificador vê em cada célula da Figure 5 (linha de cima = z2 maior):")
for r in range(15):
    print("   " + " ".join(f"{l}{'?' if c < 0.6 else ' '}" for l, c in
                         zip(lab_grid[r * 15:(r + 1) * 15], conf_grid[r * 15:(r + 1) * 15])))
print(f"   células com confiança < 0.6 (marcadas com ?): {(conf_grid < 0.6).sum()} de 225")
print(f"   dígitos que aparecem na grade: {sorted(set(lab_grid.tolist()))}; "
      f"células por dígito: {np.bincount(lab_grid, minlength=10).tolist()}")


def cell_of(z):
    """Célula (linha, coluna) da Figure 5 mais próxima de um ponto z, contando de 1."""
    col = int(np.abs(zs - z[0]).argmin()) + 1
    row = int(np.abs(zs[::-1] - z[1]).argmin()) + 1
    return row, col


print("   célula da Figure 5 mais próxima da mediana de cada dígito:",
      {k: cell_of(centers[k]) for k in range(10)})

# ---------------------------------------------------------------- custo de d = 2 (validação)
with torch.no_grad():
    rec_val = {d: m.decode(m.encode(X_val)[0]) for d, m in [(2, model2), (16, model16)]}
yv = y_val.numpy()
for d in (16, 2):
    acc = (judge(rec_val[d])[0] == yv).mean()
    print(f"E2) d = {d:2d}: o classificador acerta o dígito em {acc:.4f} das reconstruções de validação")


def within_class_spread(imgs):
    """Distância quadrática média de cada imagem até a média do seu dígito (variação de estilo)."""
    return np.mean([((imgs[yv == k] - imgs[yv == k].mean(0)) ** 2).sum(1).mean().item() for k in range(10)])


s_orig = within_class_spread(X_val)
for d in (16, 2):
    print(f"    d = {d:2d}: variação dentro do dígito nas reconstruções = {within_class_spread(rec_val[d]) / s_orig:.1%} "
          f"da variação nas imagens originais")

# ---------------------------------------------------------------- D — interpolação
IA, IB = 3, 2                                # índices de teste: um 0 e um 1
print(f"D) índices de teste: a = {IA} (dígito {y_test[IA].item()}), b = {IB} (dígito {y_test[IB].item()})")
t = torch.linspace(0, 1, 10)[:, None]


def interpolate(xa, xb):
    """Linha de cima: mistura dos pixels. Linha de baixo: mistura dos mu do modelo d = 16, decodificada."""
    pix = (1 - t) * xa + t * xb
    with torch.no_grad():
        mua, mub = model16.encode(torch.stack([xa, xb]))[0]
        lat = model16.decode((1 - t) * mua + t * mub)
    return pix, lat


pix, lat = interpolate(X_test[IA], X_test[IB])

fig, axes = plt.subplots(2, 10, figsize=(13, 3.2))
for j in range(10):
    for row, imgs in enumerate([pix, lat]):
        axes[row, j].imshow(imgs[j].reshape(28, 28), cmap="gray", vmin=0, vmax=1)
        axes[row, j].set_xticks([]); axes[row, j].set_yticks([])
    axes[0, j].set_title(f"t = {t[j].item():.2f}", fontsize=9)
axes[0, 0].set_ylabel("pixels"); axes[1, 0].set_ylabel("latente\n(d = 16)")
fig.supxlabel("t (fração do caminho da imagem a até a imagem b)", y=-0.02)
fig.suptitle(f"Figure 6 — Exercise 2: interpolação da imagem de teste {IA} (dígito {y_test[IA].item()}) "
             f"até a {IB} (dígito {y_test[IB].item()})")
fig.savefig(FIG / "fig6.png", bbox_inches="tight"); plt.close(fig)

gray = lambda imgs: ((imgs > 0.1) & (imgs < 0.9)).float().mean(1).numpy() * 100   # % de pixels "cinza"
for name, imgs in [("pixels", pix), ("latente", lat)]:
    lab, c = judge(imgs)
    print(f"   {name:7s}: dígito visto {lab.tolist()}")
    print(f"            confiança   {np.round(c, 2).tolist()}")
    print(f"            % de pixels entre 0.1 e 0.9 {np.round(gray(imgs), 1).tolist()}")


# O mesmo teste nos 45 pares formados pelas primeiras imagens de teste de cada dígito (as da Figure 2).
# Só os 8 quadros do meio (t de 0.11 a 0.89) entram na média.
first_idx = [int((y_test == k).nonzero()[0]) for k in range(10)]
stats = {"pixels": {"cinza": [], "conf": []}, "latente": {"cinza": [], "conf": []}}
for i in range(10):
    for j in range(i + 1, 10):
        for name, imgs in zip(["pixels", "latente"], interpolate(X_test[first_idx[i]], X_test[first_idx[j]])):
            stats[name]["cinza"].append(gray(imgs[1:-1]).mean())
            stats[name]["conf"].append(judge(imgs[1:-1])[1].mean())
for name in stats:
    print(f"   45 pares, {name:7s}: pixels cinza nos quadros do meio {np.mean(stats[name]['cinza']):.1f}%, "
          f"confiança média do classificador {np.mean(stats[name]['conf']):.2f}")
print(f"   pares em que a linha latente tem menos pixels cinza que a de pixels: "
      f"{(np.array(stats['latente']['cinza']) < np.array(stats['pixels']['cinza'])).sum()} de 45")
A — Train a 2-D VAE
Treinei o mesmo modelo mudando só \(d = 2\): mesmos dados, seed, \(\beta = 1\) e orçamento de treino (20 épocas, Adam \(10^{-3}\), lote 128).
| modelo | reconstrução no teste | KL no teste | \(-\)ELBO no teste |
|---|---|---|---|
| \(d = 16\) (Exercise 1) | 81.77 | 19.94 | 101.72 |
| \(d = 2\) | 133.29 | 6.75 | 140.04 |
| diferença (\(d = 2\) menos \(d = 16\)) | +51.52 | −13.20 | +38.32 |
Os valores de \(d = 2\) estão próximos da referência do enunciado (cerca de 135 e 7). Na validação, o KL de \(d = 2\) foi de 4.83 na primeira época para 6.74 na última.
B — The encoded test set
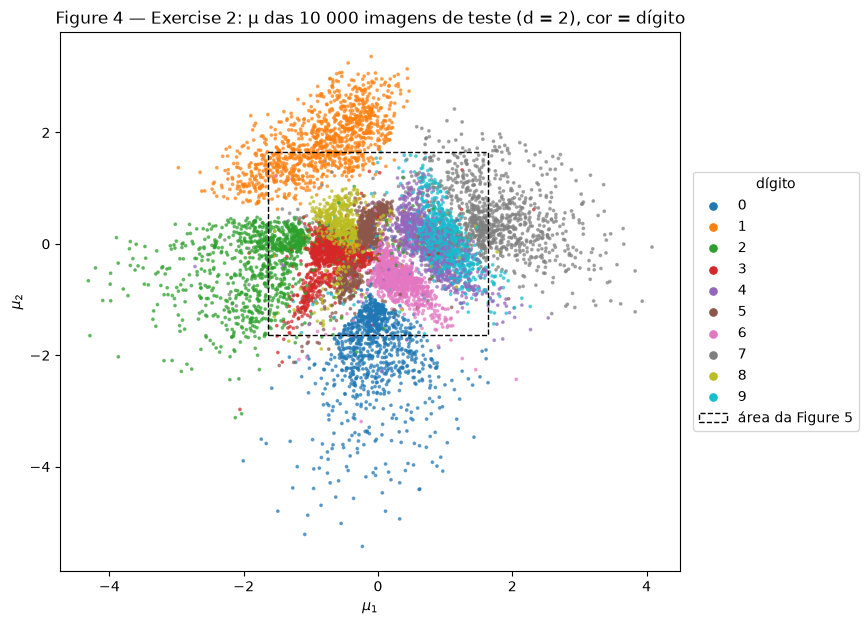
A Figure 4 mostra \(\boldsymbol{\mu}\) das 10 000 imagens de teste, com uma cor por dígito. Os pontos foram desenhados em ordem aleatória, para que nenhum dígito fique escondido sob outro. O quadrado tracejado é a área coberta pela Figure 5.
C — The decoded plane
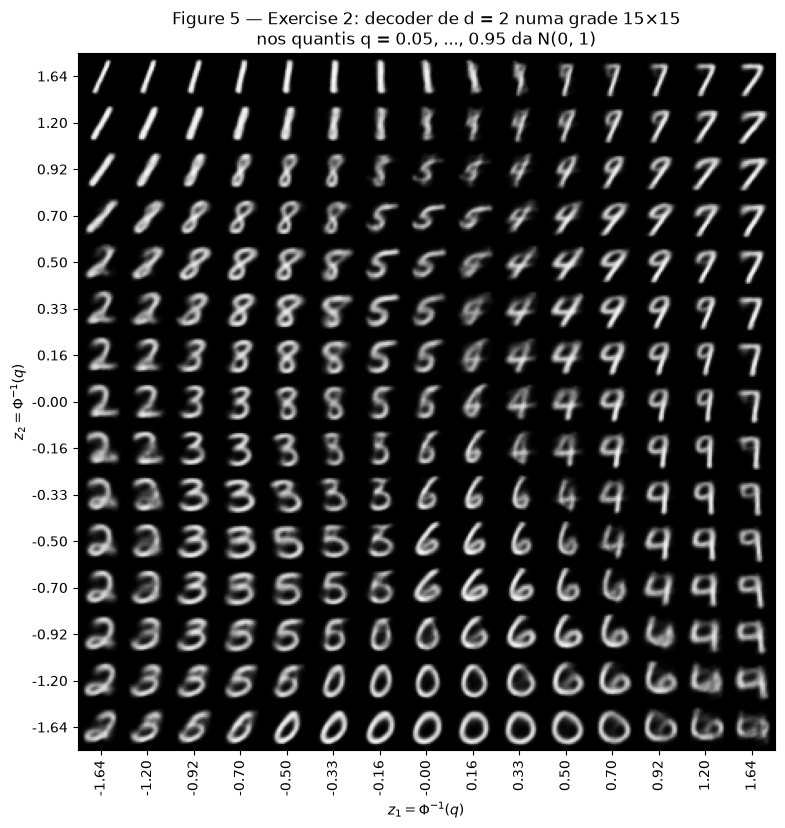
Decodifiquei uma grade de \(15 \times 15\) pontos com \(z_1\) e \(z_2\) iguais a \(\Phi^{-1}(q)\), para 15 valores de \(q\) igualmente espaçados em \([0.05, 0.95]\) (de −1.64 a 1.64). Na figura, \(z_1\) cresce da esquerda para a direita e \(z_2\) de baixo para cima, como na Figure 4.
Por que esse espaçamento: como \(q\) é a probabilidade acumulada da \(\mathcal{N}(0, 1)\) e os valores de \(q\) são igualmente espaçados, entre dois pontos vizinhos da grade há sempre a mesma massa da prior (\(0.9/14 \approx 0.064\) em cada eixo) e, como a prior é independente nos dois eixos, cada célula recebe a mesma massa da prior.
D — Interpolation
Escolhi as imagens de teste de índice 3 (um 0) e 2 (um 1), as primeiras desses dígitos no teste.
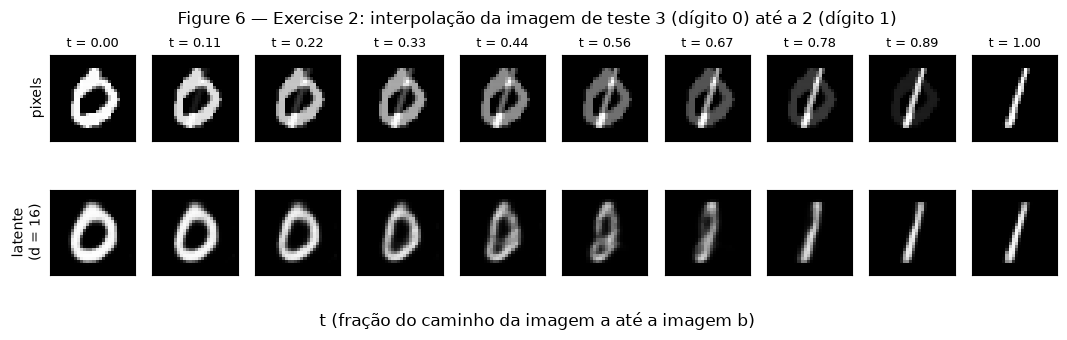
Os 10 valores de \(t\) vão de 0 a 1. A linha de cima interpola os pixels, \((1 - t)\,\mathbf{x}_a + t\,\mathbf{x}_b\). A linha de baixo interpola os códigos do modelo \(d = 16\) do Exercise 1 e decodifica, \((1 - t)\,\boldsymbol{\mu}_a + t\,\boldsymbol{\mu}_b\).
E — Analysis
Quais dígitos se sobrepõem na Figure 4? O 4 e o 9 formam quase uma única nuvem, à direita do centro: as medianas de \(\boldsymbol{\mu}\) são (0.74, 0.00) e (0.94, 0.03), a 0.2 de distância. No centro, o 3, o 5 e o 8 também se misturam. Para medir isso, usei um classificador de 15 vizinhos no plano latente, ajustado com os \(\boldsymbol{\mu}\) do treino e aplicado no teste. Ele acertou 83.19%, e os pares mais confundidos foram 4 e 9 (608 erros nos dois sentidos), 3 e 8 (172), 5 e 8 (172), 7 e 9 (116) e 3 e 5 (100).
Na Figure 5, a transição do 4 para o 9 está no lado direito. Na linha \(z_2 = 0.50\), o classificador auxiliar reconhece as células de \(z_1 = 0.33\) a \(0.70\) como 4 e a de \(z_1 = 0.92\) como 9. As imagens intermediárias são um 4 com a parte de cima cada vez mais fechada, que pode ser lido como 4 ou como 9. Algumas têm traços mais fracos, como uma sobreposição dos dois dígitos. O 3, o 5 e o 8 dividem o centro da grade da mesma forma: na linha \(z_2 = 0.00\), indo do 5 para a esquerda, as imagens passam a um 8 e depois a um 3.
O que \(d = 2\) perde. Com dois números por imagem, o modelo guarda 6.75 nats de informação sobre cada imagem, contra 19.94 com \(d = 16\). Esses dois números codificam principalmente qual é o dígito, além de inclinação e espessura. O restante do estilo (forma dos traços, voltas e detalhes de cada escrita) é perdido. A Figure 5 mostra isso: o plano contém uma versão média de cada dígito, que varia apenas em inclinação e largura, e nenhuma célula mostra um estilo diferente. Duas medidas na validação, decodificando \(\boldsymbol{\mu}\), confirmam isso:
- a variação dentro de cada dígito (distância média de cada imagem até a média do seu dígito) nas reconstruções é 72.9% da variação das imagens originais com \(d = 16\) e 34.5% com \(d = 2\);
- o classificador auxiliar reconhece o dígito correto em 95.84% das reconstruções com \(d = 16\) e em 82.79% com \(d = 2\). Nos dígitos que se sobrepõem, \(d = 2\) perde também a identidade do dígito.
Por isso a reconstrução é 51.52 nats pior.
As duas linhas da Figure 6. A linha latente passa por imagens que parecem dígitos: é uma única forma que se transforma, com o 0 ficando mais estreito e alongado até virar um 1. Os quadros de \(t = 0.44\) e \(0.56\) são os menos claros, uma forma oval e estreita entre o 0 e o 1, mas ainda formada por um único traço. A linha de pixels não passa por dígitos: ela mostra um 0 e um 1 sobrepostos, cada um com parte do brilho. Nos quadros do meio cerca de 24% dos pixels são cinza, contra 9.4% no 0 original. A média de duas imagens de dígitos em geral não é a imagem de um dígito. No espaço latente, cada imagem é uma gaussiana, e a sobreposição dessas gaussianas preenche o espaço entre os exemplos de treino (Aula 17). Por isso o segmento entre \(\boldsymbol{\mu}_a\) e \(\boldsymbol{\mu}_b\) passa por códigos que o decoder transforma em imagens plausíveis.
Repeti a comparação nos 45 pares formados pelas imagens da Figure 2. Nos quadros do meio, a linha de pixels teve 23.1% de pixels cinza e a latente 20.2%, e a latente teve menos pixels cinza em 39 dos 45 pares. A diferença é pequena porque o decoder também gera pixels cinza (20.3% no quadro latente de \(t = 0.44\)). O classificador auxiliar deu a mesma confiança média às duas linhas (0.81), porque classifica a sobreposição pelo dígito mais forte no quadro. Por isso ele não mede bem essa diferença.
Results summary
| # | Quantity | Value |
|---|---|---|
| 1 | Ex. 1 — test reconstruction, KL and negative ELBO (\(d = 16\)) | reconstrução 81.77; KL 19.94; \(-\)ELBO 101.72 nats por imagem |
| 2 | Ex. 1 — validation KL at the first and at the last epoch | 13.44 (época 1) e 19.88 (época 20) |
| 3 | Ex. 2 — test reconstruction and KL (\(d = 2\)) | reconstrução 133.29; KL 6.75 nats por imagem (\(d = 16\): 81.77 e 19.94) |
| 4 | Ex. 2 — the two test indices interpolated | 3 (dígito 0) e 2 (dígito 1) |