Exercise 2 — Perceptron
Neste exercício implementei o perceptron do zero e testei em dois casos: um em que as classes são linearmente separáveis (Exercise 1) e outro em que elas se sobrepõem (Exercise 2). A ideia é ver na prática quando o algoritmo converge e o que acontece quando ele não tem como convergir, que é onde entra o pocket.
Como fiz.
- A implementação está em
code/perceptron.py: função degrau, previsão, regra de atualização e o laço de treino. Usei só NumPy para o modelo,pandaspara montar tabelas ematplotlibpara os gráficos. Os dois exercícios importam a mesma funçãotrain_perceptron, então o Exercise 2 usa exatamente o mesmo código do Exercise 1, sem mudar nada. - Cada script começa com
rng = np.random.default_rng(42)e todos os sorteios (dados, embaralhamento e pesos iniciais) saem desse gerador. Rodando os scripts de novo, as figuras e os números saem iguais. - Depois de gerar os dados eu embaralho a ordem das amostras uma vez só, e essa ordem fica fixa durante o treino. Se não embaralhar, o perceptron vê 1000 pontos da classe 0 e depois 1000 da classe 1. Manter a ordem fixa também ajudou nas comparações do item D, porque quando eu mudo o η e mantenho o mesmo \(\mathbf{w}_0\), a única coisa diferente entre as execuções é o η.
- Usei os valores do enunciado: \(\mathbf{w}_0 \sim \mathcal{N}(0,\ 0.01)\) (desvio 0.01), \(b_0 = 0\) e \(\eta = 0.01\). O treino para quando passa uma época inteira sem nenhuma atualização ou quando chega em 100 épocas. A acurácia é calculada no dataset inteiro no fim de cada época.
- O pocket é checado depois de cada atualização, como o enunciado pede: se a acurácia no dataset inteiro for maior que a melhor que eu já tinha visto, guardo uma cópia de \((\mathbf{w}, b)\). Ele não interfere no treino, só guarda os melhores pesos.
Dificuldades. A primeira foi o tempo de execução. Checar o pocket depois de cada atualização significa calcular a acurácia nos 2000 pontos a cada erro, e no Exercise 2 são uns 700 erros por época (umas 70 mil avaliações em 100 épocas). Resolvi calculando a acurácia de forma vetorizada (X @ w + b para todos os pontos de uma vez), e com isso roda em poucos segundos. O laço de atualização continuou sendo amostra por amostra, que é como o perceptron funciona. A segunda foi entender o resultado do Exercise 2: a acurácia final depende de em que momento o treino para, então só o número não explica muita coisa. Por isso, na análise, eu também olhei onde a fronteira ficou (ângulo, deslocamento e quantos pontos ela manda para cada classe).
Também deixei tudo em um notebook, com as saídas: code/perceptron_notebook.ipynb. Os números dele são os mesmos deste relatório.
Exercise 1
Separable data. Este é o script do exercício. A implementação do perceptron que ele usa está no item B.
"""Exercise 1 — dados linearmente separáveis.

Gera figures/fig1.png, fig2.png, fig3.png e imprime os números do relatório.
Roda de qualquer diretório: python ex1_separable.py
"""
from pathlib import Path

import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

from perceptron import (ETA, train_perceptron, predict, make_dataset, plot_data,
                        plot_boundary_panel, unit)

rng = np.random.default_rng(42)
FIG = Path(__file__).resolve().parent.parent / "figures"
FIG.mkdir(exist_ok=True)

# ---------------------------------------------------------------- A — dados
mean0, mean1 = np.array([1.5, 1.5]), np.array([5.0, 5.0])
cov = np.array([[0.5, 0.0], [0.0, 0.5]])
X, y = make_dataset(rng, mean0, mean1, cov)

fig = plot_data(X, y, [mean0, mean1], "Figure 1 — Exercise 1: dados separáveis (1000 por classe)")
fig.savefig(FIG / "fig1.png", bbox_inches="tight"); plt.close(fig)
print("A) médias amostrais:", X[y == 0].mean(0).round(3), X[y == 1].mean(0).round(3))

# ---------------------------------------------------------------- C — treino (η = 0.01)
w0 = rng.normal(0.0, 0.01, size=2)          # inicialização do enunciado; b = 0
res = train_perceptron(X, y, eta=ETA, w0=w0)

print(f"C) w0 = {w0}")
print(f"   w = [{res['w'][0]:.5f}, {res['w'][1]:.5f}], b = {res['b']:.5f}")
print(f"   épocas = {res['epochs']} (convergiu: {res['converged']}), acurácia = {res['acc']:.4f}")
print(f"   atualizações por época: {res['updates_hist'].tolist()}")

fig, ax = plt.subplots(figsize=(6, 5.5))
plot_boundary_panel(ax, X, y, res["w"], res["b"],
                    "Figure 2 — Exercise 1: fronteira de decisão final (η = 0.01)",
                    "fronteira $w\\cdot x + b = 0$")
ax.set_aspect("equal")
fig.savefig(FIG / "fig2.png", bbox_inches="tight"); plt.close(fig)

epochs = np.arange(1, res["epochs"] + 1)
fig, ax = plt.subplots(figsize=(6.5, 4))
ax.plot(epochs, res["acc_hist"], "o-", label="acurácia no fim da época")
ax.set_xticks(epochs); ax.set_ylim(0.45, 1.02)
ax.set_xlabel("época"); ax.set_ylabel("acurácia (dataset inteiro)")
ax.set_title("Figure 3 — Exercise 1: acurácia por época (η = 0.01)")
ax.legend()
fig.savefig(FIG / "fig3.png", bbox_inches="tight"); plt.close(fig)

# ---------------------------------------------------------------- D — η = 1.0, mesmo w0 e mesma ordem
res1 = train_perceptron(X, y, eta=1.0, w0=w0)
cos_dir = float(unit(res["w"]) @ unit(res1["w"]))
print(f"D) η = 1.0: épocas = {res1['epochs']}, acurácia = {res1['acc']:.4f}, "
      f"w = {res1['w'].round(4)}, b = {res1['b']:.4f}, atualizações {res1['updates_hist'].tolist()}")
print(f"   w/||w||: η=0.01 {unit(res['w']).round(4)} | η=1.0 {unit(res1['w']).round(4)}")
print(f"   cosseno = {cos_dir:.4f}, ângulo = {np.degrees(np.arccos(np.clip(cos_dir, -1, 1))):.2f}°")
print(f"   ||w0|| = {np.linalg.norm(w0):.4f}; ||w|| final: "
      f"{np.linalg.norm(res['w']):.4f} (η=0.01) vs {np.linalg.norm(res1['w']):.4f} (η=1.0)")

# ---------------------------------------------------------------- D — partindo de w = 0, b = 0
z1 = train_perceptron(X, y, eta=0.01, w0=np.zeros(2))
z2 = train_perceptron(X, y, eta=1.0, w0=np.zeros(2))
print(f"D) w0 = 0: η=0.01 -> w = {z1['w']}, b = {z1['b']:.4f}, épocas = {z1['epochs']}")
print(f"           η=1.00 -> w = {z2['w']}, b = {z2['b']:.4f}, épocas = {z2['epochs']}")
print(f"   razão w = {z2['w'] / z1['w']}, razão b = {z2['b'] / z1['b']:.6f}")
print("   previsões idênticas:",
      bool(np.all(predict(X, z1["w"], z1["b"]) == predict(X, z2["w"], z2["b"]))),
      "| atualizações:", z1["updates_hist"].tolist(), z2["updates_hist"].tolist())
A — Generate the data
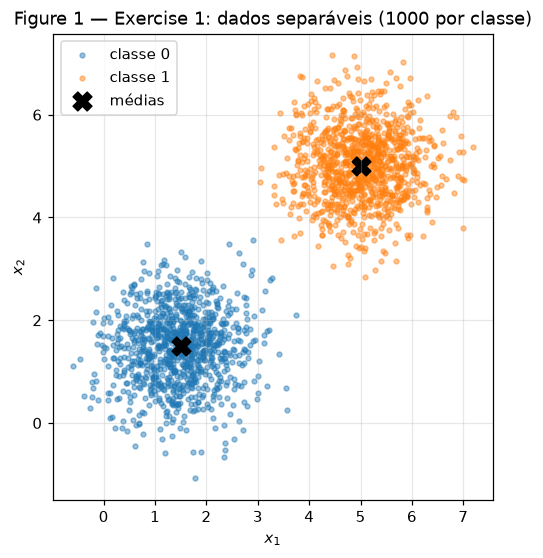
Gerei 1000 amostras por classe com \(\mathcal{N}(\mu, \Sigma)\) e \(\Sigma = 0.5\,I\): a classe 0 com \(\mu_0 = (1.5,\ 1.5)\) e a classe 1 com \(\mu_1 = (5,\ 5)\). As médias das amostras ficaram (1.450, 1.473) e (5.010, 5.013), bem perto das médias teóricas. A distância entre os centros é \(3.5\sqrt 2 \approx 4.95\), e o desvio em cada eixo é \(\sqrt{0.5} \approx 0.71\). Ou seja, cada centro fica a uns 3.5 desvios da reta que divide os dois, e dá para ver na figura que as nuvens não se encostam.
B — Implement the perceptron
O modelo e a regra de atualização que implementei:
Como \(y - \hat y\) só pode ser \(-1\), \(0\) ou \(+1\), os pesos só mudam quando o modelo erra. Se o ponto é da classe 1 e o modelo previu 0, soma \(\eta\mathbf{x}\) em \(\mathbf{w}\); se é da classe 0 e previu 1, subtrai.
"""Perceptron escrito do zero (NumPy) + geração de dados e figuras.

Usado por ex1_separable.py e ex2_overlapping.py. O modelo (degrau, previsão,
regra de atualização e laço de treino com pocket) está todo aqui; nada vem de
bibliotecas de ML.
"""
import numpy as np
import matplotlib.pyplot as plt

N_PER_CLASS = 1000
MAX_EPOCHS = 100
ETA = 0.01

plt.rcParams.update({"figure.dpi": 110, "axes.grid": True, "grid.alpha": 0.3})
COLORS = {0: "tab:blue", 1: "tab:orange"}


# ---------------------------------------------------------------- modelo

def step(z):
    """Função degrau: 1 se z >= 0, senão 0."""
    return np.where(z >= 0, 1, 0)


def predict(X, w, b):
    """Previsão do perceptron: degrau aplicado a w·x + b (X pode ser uma amostra ou uma matriz)."""
    return step(X @ w + b)


def accuracy(X, y, w, b):
    """Fração de acertos no dataset inteiro."""
    return float(np.mean(predict(X, w, b) == y))


def train_perceptron(X, y, eta, w0, b0=0.0, max_epochs=MAX_EPOCHS):
    """Regra de aprendizado do perceptron, amostra a amostra.

    Para cada amostra (x_i, y_i), na ordem fixa do dataset:
        y_hat = step(w·x_i + b)
        w <- w + eta * (y_i - y_hat) * x_i
        b <- b + eta * (y_i - y_hat)
    Só há atualização quando y_hat != y_i. O treino para quando uma época inteira
    passa sem nenhuma atualização (convergiu) ou ao atingir max_epochs.

    Além dos pesos correntes, guarda o "pocket": toda vez que uma atualização
    produz acurácia no dataset inteiro maior do que qualquer outra já vista,
    copia (w, b) para o bolso. O pocket não interfere no treino.
    """
    w = np.asarray(w0, dtype=float).copy()
    b = float(b0)

    pocket_w, pocket_b = w.copy(), b
    pocket_acc = accuracy(X, y, w, b)
    pocket_epoch = 0                       # 0 = pesos iniciais, antes de qualquer época

    acc_hist, pocket_hist, updates_hist = [], [], []
    converged = False

    for epoch in range(1, max_epochs + 1):
        n_updates = 0
        for x_i, y_i in zip(X, y):
            y_hat = 1 if x_i @ w + b >= 0 else 0
            error = y_i - y_hat            # +1, 0 ou -1
            if error != 0:
                w = w + eta * error * x_i
                b = b + eta * error
                n_updates += 1

                # Pocket: avalia no dataset inteiro depois de cada atualização
                acc_now = accuracy(X, y, w, b)
                if acc_now > pocket_acc:
                    pocket_w, pocket_b = w.copy(), b
                    pocket_acc, pocket_epoch = acc_now, epoch

        acc_hist.append(accuracy(X, y, w, b))   # acurácia no fim da época
        pocket_hist.append(pocket_acc)
        updates_hist.append(n_updates)

        if n_updates == 0:
            converged = True
            break

    return {
        "w": w, "b": b, "epochs": epoch, "converged": converged,
        "acc": acc_hist[-1], "acc_hist": np.array(acc_hist),
        "updates_hist": np.array(updates_hist),
        "pocket_w": pocket_w, "pocket_b": pocket_b,
        "pocket_acc": pocket_acc, "pocket_epoch": pocket_epoch,
        "pocket_hist": np.array(pocket_hist),
    }


# ---------------------------------------------------------------- dados

def make_dataset(rng, mean0, mean1, cov, n=N_PER_CLASS):
    """Sorteia as duas classes e embaralha a ordem uma única vez.

    O embaralhamento importa: sem ele o perceptron veria 1000 amostras da
    classe 0 seguidas de 1000 da classe 1. A ordem fica fixa durante o treino.
    """
    X0 = rng.multivariate_normal(mean0, cov, size=n)
    X1 = rng.multivariate_normal(mean1, cov, size=n)
    X = np.vstack([X0, X1])
    y = np.concatenate([np.zeros(n, dtype=int), np.ones(n, dtype=int)])
    order = rng.permutation(len(y))
    return X[order], y[order]


# ---------------------------------------------------------------- figuras

def scatter_classes(ax, X, y, alpha=0.5):
    for c in (0, 1):
        ax.scatter(*X[y == c].T, s=10, alpha=alpha, color=COLORS[c], label=f"classe {c}")


def draw_boundary(ax, w, b, X, **kw):
    """Desenha a reta w1*x1 + w2*x2 + b = 0 dentro dos limites dos dados."""
    x1 = np.linspace(X[:, 0].min() - 0.5, X[:, 0].max() + 0.5, 200)
    if abs(w[1]) > 1e-12:
        ax.plot(x1, -(w[0] * x1 + b) / w[1], **kw)
    else:                                   # reta vertical
        ax.axvline(-b / w[0], **kw)


def plot_boundary_panel(ax, X, y, w, b, title, line_label, line_color="k"):
    """Dados + fronteira + pontos mal classificados (círculo vermelho)."""
    scatter_classes(ax, X, y, alpha=0.35)
    wrong = predict(X, w, b) != y
    ax.scatter(*X[wrong].T, s=28, facecolors="none", edgecolors="red", linewidths=0.9,
               label=f"mal classificados ({wrong.sum()})")
    draw_boundary(ax, w, b, X, color=line_color, lw=2, label=line_label)
    ax.set_xlim(X[:, 0].min() - 0.5, X[:, 0].max() + 0.5)
    ax.set_ylim(X[:, 1].min() - 0.5, X[:, 1].max() + 0.5)
    ax.set_xlabel("$x_1$"); ax.set_ylabel("$x_2$"); ax.set_title(title)
    ax.legend(loc="upper left", fontsize=8)


def plot_data(X, y, means, title):
    fig, ax = plt.subplots(figsize=(6, 5.5))
    scatter_classes(ax, X, y, alpha=0.45)
    ax.scatter(*np.vstack(means).T, marker="X", s=150, color="k", label="médias")
    ax.set_xlabel("$x_1$"); ax.set_ylabel("$x_2$"); ax.set_title(title)
    ax.legend(); ax.set_aspect("equal")
    return fig


def unit(v):
    return v / np.linalg.norm(v)
C — Train and measure
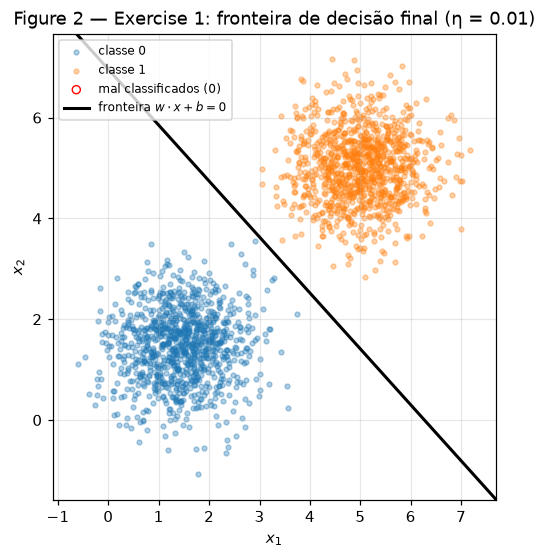
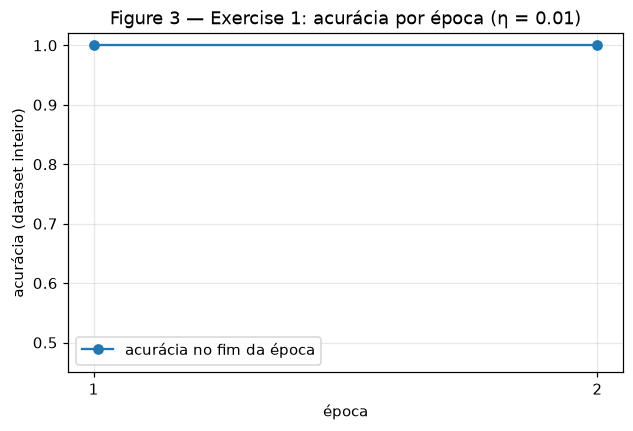
Treinei com \(\eta = 0.01\), e o \(\mathbf{w}_0\) sorteado foi \([0.00991,\ -0.00827]\). O treino terminou em 2 épocas: na primeira teve 48 atualizações e no fim dela todos os pontos já estavam certos; na segunda não teve nenhum erro, e por isso o treino parou.
| valor | |
|---|---|
| \(\mathbf{w}\) final | [0.03189, 0.02874] |
| \(b\) final | −0.20 |
| épocas | 2 (48 atualizações, depois 0) |
| acurácia | 100% |
A reta \(0.03189\,x_1 + 0.02874\,x_2 - 0.20 = 0\) cruza a diagonal em \(x_1 = x_2 \approx 3.30\), perto do ponto médio entre os centros (3.25, 3.25), e o vetor \(\mathbf{w}\) aponta quase na direção \((1, 1)\). Nenhum ponto ficou mal classificado.
D — Analysis
1. Por que converge tão rápido? A regra só atualiza quando erra, e toda atualização melhora a saída naquele ponto: se era um falso negativo, \(\mathbf{w}\cdot\mathbf{x} + b\) aumenta \(\eta(\lVert\mathbf{x}\rVert^2 + 1)\); se era um falso positivo, diminui o mesmo tanto. O teorema de convergência do perceptron (Novikoff) diz que, se existe uma reta que separa os dados com margem \(\gamma\), o número total de erros é no máximo \((R/\gamma)^2\), onde \(R\) é o maior \(\lVert\mathbf{x}\rVert\). Aqui a margem é grande em relação a \(R\), porque as nuvens estão bem longe da reta que as separa, então esse limite é pequeno, e de fato foram só 48 erros. Além disso, como o \(\mathbf{w}_0\) é muito pequeno, logo nas primeiras atualizações o \(\mathbf{w}\) vira basicamente uma soma de pontos da classe 1 menos pontos da classe 0, e isso aponta mais ou menos para \(\mu_1 - \mu_0 \propto (1, 1)\), que já é uma boa direção.
2. Rodando de novo com \(\eta = 1.0\) (mesmo \(\mathbf{w}_0\) e mesma ordem): também deu 2 épocas e 100% de acurácia, mas com 25 atualizações na primeira época em vez de 48. Os pesos finais foram \(\mathbf{w} = [1.717,\ 1.665]\) e \(b = -11\).
| \(\eta = 0.01\) | \(\eta = 1.0\) | |
|---|---|---|
| \(\mathbf{w}/\lVert\mathbf{w}\rVert\) | [0.7429, 0.6694] | [0.7181, 0.6960] |
| \(\lVert\mathbf{w}\rVert\) | 0.043 | 2.392 |
| atualizações | 48, 0 | 25, 0 |
Os pesos ficaram uns 56 vezes maiores, mas a direção é quase a mesma: o cosseno entre os dois vetores normalizados deu 0.9993, um ângulo de 2.1°. Então o η não muda muito a solução, ele muda o tamanho do passo comparado com o \(\mathbf{w}_0\). A fronteira \(\mathbf{w}\cdot\mathbf{x} + b = 0\) continua a mesma se eu multiplicar \((\mathbf{w}, b)\) por um número positivo, e a regra só olha o sinal de \(\mathbf{w}\cdot\mathbf{x} + b\). Com \(\eta = 0.01\), o \(\mathbf{w}_0\) (\(\lVert\mathbf{w}_0\rVert = 0.013\)) tem mais ou menos o tamanho de um passo, então ele ainda influencia quais pontos saem errados no começo. Com \(\eta = 1\) o primeiro passo já é muito maior que ele. Acho que é daí que vêm a diferença de 48 para 25 erros e os 2° de diferença na direção.
3. Começando com \(\mathbf{w} = 0\) e \(b = 0\), o η só muda a escala dos pesos. Mostrei por indução. Chamo de \((\mathbf{w}^{(t)}_1, b^{(t)}_1)\) e \((\mathbf{w}^{(t)}_2, b^{(t)}_2)\) os pesos depois de \(t\) amostras nas execuções com \(\eta_1\) e \(\eta_2\), e a hipótese é que \(\mathbf{w}^{(t)}_2 = \tfrac{\eta_2}{\eta_1}\mathbf{w}^{(t)}_1\) e \(b^{(t)}_2 = \tfrac{\eta_2}{\eta_1} b^{(t)}_1\).
- Base (\(t = 0\)): os dois são zero, então vale para qualquer fator.
- Passo: para a próxima amostra \((\mathbf{x}, y)\), \(\mathbf{w}^{(t)}_2\cdot\mathbf{x} + b^{(t)}_2 = \tfrac{\eta_2}{\eta_1}\left(\mathbf{w}^{(t)}_1\cdot\mathbf{x} + b^{(t)}_1\right)\). Como \(\eta_2/\eta_1 > 0\), o sinal é o mesmo, então \(\hat y_2 = \hat y_1\) e o erro \(e = y - \hat y\) também é o mesmo. Daí:
e para o \(b\) é igual. Então as duas execuções erram nos mesmos pontos, na mesma ordem, param na mesma época, e os pesos finais só diferem pelo fator \(\eta_2/\eta_1\). A fronteira é a mesma.
Também conferi isso no script com \(\eta_1 = 0.01\) e \(\eta_2 = 1\): deu \(\mathbf{w}_1 = [0.017074,\ 0.016729]\) e \(b_1 = -0.11\), e \(\mathbf{w}_2 = [1.7074,\ 1.6729]\) e \(b_2 = -11\). A razão foi exatamente 100 nas três coordenadas, as previsões foram iguais nos 2000 pontos e as atualizações por época também (25 e depois 0).
Quando \(\mathbf{w}_0 \ne 0\) a indução não funciona já na base, porque \(\mathbf{w}_0 \ne \tfrac{\eta_2}{\eta_1}\mathbf{w}_0\), e por isso no item 2 as direções ficaram um pouco diferentes. Uma coisa que eu achei interessante: a execução com \(\eta = 1\) do item 2 e a que começa do zero no item 3 deram quase o mesmo resultado (\([1.717,\ 1.665]\) e \([1.707,\ 1.673]\), as duas com 25 erros). Com um passo grande, o \(\mathbf{w}_0\) pequeno praticamente não faz diferença.
Exercise 2
Overlapping data. Script do exercício. Ele importa a mesma train_perceptron do Exercise 1, sem nenhuma mudança.
"""Exercise 2 — dados sobrepostos, perceptron + pocket.

Gera figures/fig4.png, fig5.png, fig6.png e imprime os números do relatório.
Roda de qualquer diretório: python ex2_overlapping.py
"""
from math import erf, sqrt
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

from perceptron import (ETA, train_perceptron, predict, accuracy, make_dataset, plot_data,
                        plot_boundary_panel, draw_boundary)

rng = np.random.default_rng(42)
FIG = Path(__file__).resolve().parent.parent / "figures"
FIG.mkdir(exist_ok=True)

# ---------------------------------------------------------------- A — dados
mean0, mean1 = np.array([3.0, 3.0]), np.array([4.0, 4.0])
cov = np.array([[1.5, 0.0], [0.0, 1.5]])
X, y = make_dataset(rng, mean0, mean1, cov)

fig = plot_data(X, y, [mean0, mean1], "Figure 4 — Exercise 2: dados sobrepostos (1000 por classe)")
fig.savefig(FIG / "fig4.png", bbox_inches="tight"); plt.close(fig)

# ---------------------------------------------------------------- B — treino com pocket (mesma função do Ex. 1)
w0 = rng.normal(0.0, 0.01, size=2)
res = train_perceptron(X, y, eta=ETA, w0=w0)

print(f"B) épocas = {res['epochs']} (convergiu: {res['converged']})")
print(f"   FINAL : w = [{res['w'][0]:.5f}, {res['w'][1]:.5f}], b = {res['b']:.5f}, acurácia = {res['acc']:.4f}")
print(f"   POCKET: w = [{res['pocket_w'][0]:.5f}, {res['pocket_w'][1]:.5f}], b = {res['pocket_b']:.5f}, "
      f"acurácia = {res['pocket_acc']:.4f}, época {res['pocket_epoch']}")
u = res["updates_hist"]
print(f"   atualizações por época: média {u.mean():.0f}, mín {u.min()}, máx {u.max()}")
h = res["acc_hist"]
print(f"   acurácia corrente nas 100 épocas: mín {h.min():.4f}, máx {h.max():.4f}, média {h.mean():.4f}")
print(f"   pocket ao fim da época 1: {res['pocket_hist'][0]:.4f}")

# ---------------------------------------------------------------- C — figuras
fig, axes = plt.subplots(1, 2, figsize=(12, 5.5), sharex=True, sharey=True)
plot_boundary_panel(axes[0], X, y, res["w"], res["b"],
                    f"Final (época {res['epochs']}): acurácia {res['acc']:.1%}",
                    "fronteira final", line_color="k")
draw_boundary(axes[0], res["pocket_w"], res["pocket_b"], X, color="green", lw=1.5, ls="--",
              label="fronteira pocket (ref.)")
axes[0].legend(loc="upper left", fontsize=8)
plot_boundary_panel(axes[1], X, y, res["pocket_w"], res["pocket_b"],
                    f"Pocket (época {res['pocket_epoch']}): acurácia {res['pocket_acc']:.1%}",
                    "fronteira pocket", line_color="green")
draw_boundary(axes[1], res["w"], res["b"], X, color="k", lw=1.5, ls="--",
              label="fronteira final (ref.)")
axes[1].legend(loc="upper left", fontsize=8)
fig.suptitle("Figure 5 — Exercise 2: fronteiras final e pocket "
             "(vermelho = mal classificado pela fronteira do painel)")
fig.tight_layout()
fig.savefig(FIG / "fig5.png", bbox_inches="tight"); plt.close(fig)

epochs = np.arange(1, res["epochs"] + 1)
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(epochs, res["acc_hist"], lw=1.2, label="acurácia corrente (fim da época)")
ax.plot(epochs, res["pocket_hist"], lw=2, color="green", label="acurácia do pocket")
ax.axhline(0.5, color="gray", ls=":", lw=1, label="chute (50%)")
ax.set_ylim(0.4, 0.8)
ax.set_xlabel("época"); ax.set_ylabel("acurácia (dataset inteiro)")
ax.set_title("Figure 6 — Exercise 2: acurácia corrente vs. pocket (η = 0.01)")
ax.legend(loc="lower right")
fig.savefig(FIG / "fig6.png", bbox_inches="tight"); plt.close(fig)

# ---------------------------------------------------------------- D — onde estão as fronteiras
midpoint = (mean0 + mean1) / 2
for name, w, b in [("final", res["w"], res["b"]), ("pocket", res["pocket_w"], res["pocket_b"])]:
    p1 = predict(X, w, b).mean()
    dist = (midpoint @ w + b) / np.linalg.norm(w)
    ang = np.degrees(np.arctan2(w[1], w[0]))
    print(f"D) {name:>6}: prevê classe 1 em {p1:.1%} | ângulo de w = {ang:.1f}° "
          f"| distância com sinal de (3.5, 3.5) à reta = {dist:+.3f}")

# Teto teórico de uma reta: covariâncias iguais e isotrópicas -> mediatriz, erro Φ(−‖Δμ‖/2σ)
z = np.linalg.norm(mean1 - mean0) / (2 * sqrt(cov[0, 0]))
print(f"D) melhor reta teórica: Φ({z:.4f}) = {0.5 * (1 + erf(z / sqrt(2))):.4f}; "
      f"reta de Bayes (w=[1,1], b=-7) nesta amostra: {accuracy(X, y, np.array([1.0, 1.0]), -7.0):.4f}")

# ---------------------------------------------------------------- D — mais épocas ou η menor?
rows = []
for eta in (1.0, 0.01, 0.001):
    r = train_perceptron(X, y, eta=eta, w0=w0, max_epochs=500)
    tail = r["acc_hist"][-100:]
    rows.append({"eta": eta, "épocas": r["epochs"], "convergiu": r["converged"],
                 "acc final": r["acc"], "acc últ.100 mín": tail.min(), "acc últ.100 máx": tail.max(),
                 "pocket": r["pocket_acc"], "época pocket": r["pocket_epoch"],
                 "atualiz./época": r["updates_hist"].mean()})
print("D) 500 épocas, mesmo w0:")
print(pd.DataFrame(rows).round(4).to_string(index=False))
A — Generate the data
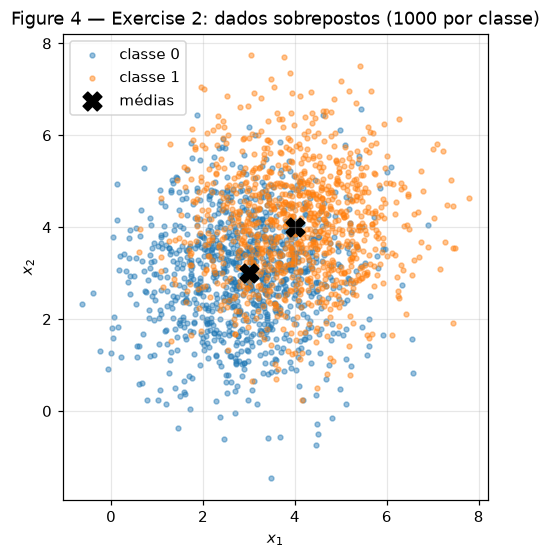
De novo 1000 amostras por classe, agora com \(\Sigma = 1.5\,I\): a classe 0 com \(\mu_0 = (3,\ 3)\) e a classe 1 com \(\mu_1 = (4,\ 4)\). Agora a distância entre os centros é só \(\sqrt 2 \approx 1.41\), e cada centro fica a \(0.71 / 1.22 \approx 0.58\) desvio da reta do meio. Na figura dá para ver que as duas nuvens ficam praticamente uma em cima da outra, então não existe reta que separe tudo.
B — Train, keeping the best weights
Usei a mesma função, com \(\eta = 0.01\) e um \(\mathbf{w}_0 \sim \mathcal{N}(0,\ 0.01)\) novo. Dessa vez o treino foi até as 100 épocas sem convergir: em todas as épocas teve entre 658 e 761 atualizações (701 em média).
| \(\mathbf{w}\) | \(b\) | acurácia | |
|---|---|---|---|
| Final (época 100) | [0.07538, 0.08603] | −0.41 | 63.90% |
| Pocket (época 23) | [0.05678, 0.06367] | −0.42 | 73.30% |
C — Figures
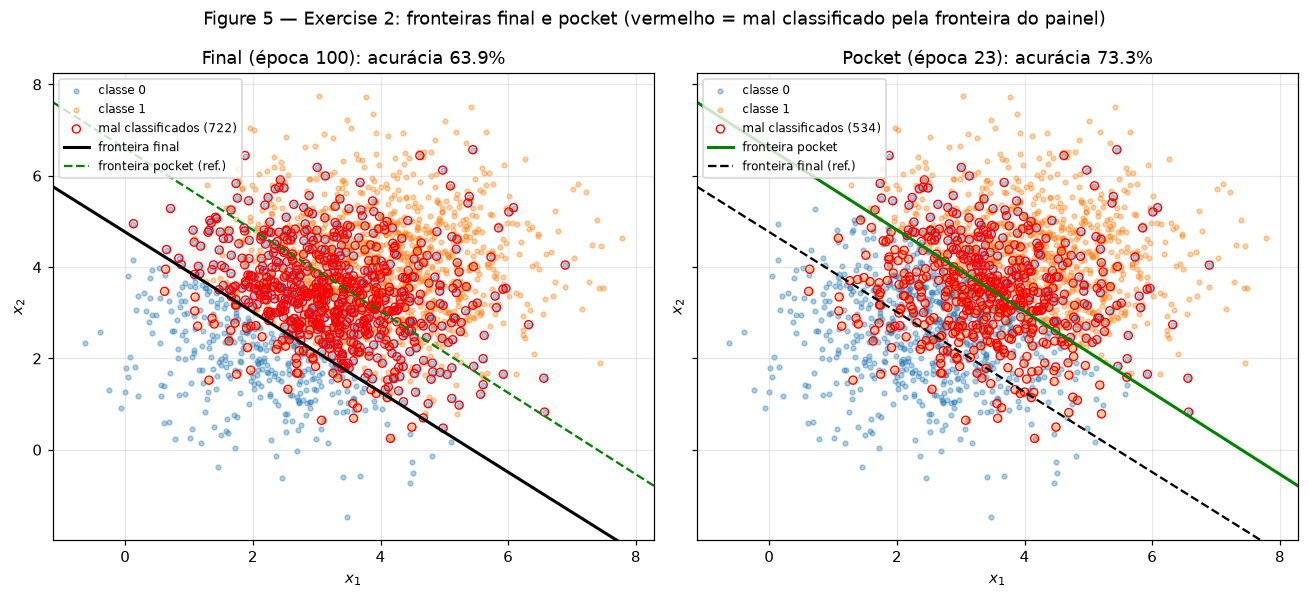
Na Figura 5 os círculos vermelhos são os pontos que a fronteira daquele painel erra. A outra fronteira aparece tracejada só para comparar.
D — Analysis
Para entender onde cada fronteira ficou, calculei no script três coisas: quantos pontos ela classifica como classe 1, o ângulo do \(\mathbf{w}\) (o ideal seria 45°, na direção de \(\mu_1 - \mu_0\)) e a distância com sinal entre o ponto médio (3.5, 3.5) e a reta (o ideal seria 0, porque a melhor reta passa por esse ponto).
| prevê classe 1 | ângulo de \(\mathbf{w}\) | distância de (3.5, 3.5) à reta | acurácia | |
|---|---|---|---|---|
| Final | 81.2% | 48.8° | +1.355 | 63.90% |
| 50.1% | 48.3° | +0.019 | 73.30% | |
| Reta de Bayes (\(x_1 + x_2 = 7\)) | — | 45.0° | 0 | 72.60% |
1. Por que o final e o pocket ficam tão diferentes? O pocket chegou praticamente no máximo que uma reta consegue nesses dados. Como as duas classes têm a mesma covariância, a melhor reta é a que passa no meio dos dois centros, e a acurácia teórica dela é \(\Phi(\lVert\mu_1 - \mu_0\rVert / 2\sigma) = \Phi(0.577) = 71.8\%\). Nesta amostra essa reta acerta 72.6%. O pocket ficou um pouco acima (73.3%) porque ele pega a melhor reta para esses 2000 pontos específicos. A fronteira dele passa a 0.02 do ponto médio e divide os pontos quase meio a meio.
A fronteira final tem quase o mesmo ângulo (48.8° contra 48.3°), mas está deslocada: ela passa 1.36 unidades abaixo e à esquerda do ponto médio, e por isso manda 81.2% dos pontos para a classe 1. Ela acerta quase toda a classe 1 e erra muita coisa da classe 0 (painel da esquerda da Figura 5). Então o problema dela não é a inclinação, é a posição.
O motivo é que, com as classes sobrepostas, sempre tem ponto errado, então o perceptron nunca para de atualizar. Cada erro muda o \(b\) em \(\pm\eta\) e o \(\mathbf{w}\) em \(\pm\eta\mathbf{x}\): um ponto da classe 1 errado puxa a reta para baixo e para a esquerda, e um ponto da classe 0 errado puxa para cima e para a direita. Na região onde as nuvens se misturam isso não acaba nunca, e a reta fica indo e voltando em volta da posição boa. A fronteira da época 100 é simplesmente onde a reta estava quando o treino acabou, e nada garante que seja uma posição boa. É para isso que serve o pocket: ele não muda o treino, só guarda o melhor momento.
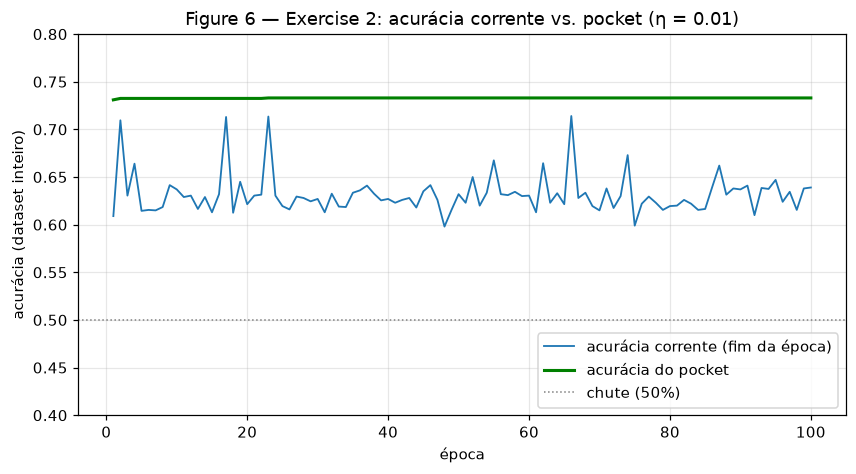
2. Comparando as Figuras 3 e 6. Na Figura 3 a acurácia chega a 100% e o treino para sozinho porque uma época inteira passa sem erro. Na Figura 6 a acurácia corrente fica oscilando entre 59.8% e 71.4% do começo ao fim, sem subir, enquanto a do pocket já estava em 73.1% no fim da primeira época e chegou a 73.3% na época 23, e não mudou mais.
O teorema de convergência diz que, se existir um \((\mathbf{w}^*, b^*)\) com \(y_i'(\mathbf{w}^*\cdot\mathbf{x}_i + b^*) \ge \gamma > 0\) para todo \(i\) (usando \(y' = \pm 1\)), o perceptron faz no máximo \((R/\gamma)^2\) atualizações, ou seja, ele para depois de um número finito de passos e com erro zero. A hipótese que falha aqui é a de que os dados são linearmente separáveis (margem \(\gamma > 0\)). Como nenhuma reta acerta todos os pontos, o teorema não garante nada, e o que acontece na prática é que os pesos ficam mudando para sempre. E mesmo quando os dados não são separáveis, o teorema não fala nada sobre achar a reta que erra menos.
3. Mais épocas ou um η menor resolveriam? Não. Para testar, rodei de novo com 500 épocas, o mesmo \(\mathbf{w}_0\) e três valores de η:
| \(\eta\) | acurácia final | corrente nas últimas 100 épocas (mín–máx) | atualizações/época | |
|---|---|---|---|---|
| 1.0 | 63.35% | 59.45% – 71.40% | 700 | 73.40% |
| 0.01 | 66.50% | 59.45% – 71.35% | 700 | 73.35% |
| 0.001 | 63.45% | 59.75% – 66.80% | 701 | 73.35% |
- Mais épocas: o treino só para quando passa uma época sem erro, e isso nunca vai acontecer, porque sempre tem ponto que nenhuma reta acerta. Rodar mais épocas é só repetir o mesmo vai e volta. Com 500 épocas a acurácia corrente ficou oscilando na mesma faixa que com 100.
- η menor: pelo item 3 do Exercise 1, quando o \(\mathbf{w}_0\) é bem pequeno o η basicamente só muda a escala de \((\mathbf{w}, b)\), e a fronteira só depende da direção de \(\mathbf{w}\) e de \(b/\lVert\mathbf{w}\rVert\). Então diminuir o η não deixa os passos menores em relação aos pesos, porque os pesos também ficam menores. Os erros acontecem quase na mesma sequência, e é por isso que as três linhas da tabela ficaram tão parecidas. O que poderia fazer os pesos pararem de oscilar seria um η que diminui ao longo do treino (tipo \(\eta_t \propto 1/t\)), ou usar uma função de perda contínua (como a logística ou a hinge) em vez de olhar só o sinal. Mas, com o perceptron do jeito que ele é, a solução é o pocket.
Results summary
| # | Quantity | Value |
|---|---|---|
| 1 | Exercise 1 — final \(\mathbf{w}\) and \(b\) | \(\mathbf{w}\) = [0.03189, 0.02874], \(b\) = −0.20000 |
| 2 | Exercise 1 — epochs to convergence | 2 (48 atualizações na 1ª época, 0 na 2ª) |
| 3 | Exercise 1 — final accuracy | 1.0000 (100%) |
| 4 | Exercise 1 — epochs and final accuracy with \(\eta = 1.0\) | 2 épocas, 1.0000 (100%) |
| 5 | Exercise 2 — final \(\mathbf{w}\) and \(b\) | \(\mathbf{w}\) = [0.07538, 0.08603], \(b\) = −0.41000 |
| 6 | Exercise 2 — accuracy of the final weights | 0.6390 |
| 7 | Exercise 2 — accuracy of the pocket weights | 0.7330 |
| 8 | Exercise 2 — epoch at which the pocket best occurred | 23 |