Exercise 1 — Data
Preparacao e analise de dados para redes neurais. O fio condutor e o espalhamento dos dados: quanto uma nuvem de pontos se espalha, em que direcao, e como isso muda a dificuldade do problema de classificacao.
Todo sorteio usa rng = np.random.default_rng(42), declarado uma vez no topo de cada script. Os tres scripts estao em code/ e sao executaveis de forma independente a partir de um checkout limpo.
Exercise 1
Abordagem. Tudo neste exercicio e geometrico, nada e treinado. As nuvens sao geradas a partir dos parametros e medidas por duas grandezas: a razao de separacao (distancia entre centros dividida pelo espalhamento das duas nuvens) e a taxa de mistura (fracao de pontos mais proxima de um centro alheio). As duas sao calculadas em NumPy e indicam, antes de qualquer modelo, o quao dificil e o problema.
"""Exercise 1 - Point clouds: geometry and spread in 2D.

Gera as quatro nuvens gaussianas, mede a razao de separacao e a taxa de mistura
para cada fator de escala, e salva as Figuras 1, 1b, 2 e 3 em ../figures/.

Uso:  python ex1_point_clouds.py
"""

import os

import numpy as np
import pandas as pd
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt

# Semente unica do relatorio.
rng = np.random.default_rng(42)

FIG_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "figures")
os.makedirs(FIG_DIR, exist_ok=True)

NAMES = ["Class 0", "Class 1", "Class 2", "Class 3"]
MEAN = np.array([[2, 3], [5, 6], [8, 1], [15, 4]], dtype=float)
STD = np.array([[0.8, 2.5], [1.2, 1.9], [0.9, 0.9], [0.5, 2.0]], dtype=float)
N = 100
SCALES = [0.5, 1.0, 2.0, 4.0]

# Ruido padrao sorteado uma unica vez e reaproveitado em todas as escalas, para
# que os paineis da Figura 2 mostrem as mesmas nuvens dilatando.
Z = rng.normal(0, 1, size=(len(MEAN), N, 2))


def generate_clouds(mean, std, z, scale=1.0):
    """As medias ficam fixas; todo desvio e multiplicado por `scale`."""
    X = mean[:, None, :] + (std * scale)[:, None, :] * z
    return X.reshape(-1, 2), np.repeat(np.arange(len(mean)), z.shape[1])


def separation_table(mean, std):
    """r_ij = ||mu_i - mu_j|| / (sigma_bar_i + sigma_bar_j)."""
    sigma_bar = std.mean(axis=1)
    linhas = []
    for i in range(len(mean)):
        for j in range(i + 1, len(mean)):
            dist = np.linalg.norm(mean[i] - mean[j])
            denom = sigma_bar[i] + sigma_bar[j]
            linhas.append(
                {
                    "pair": f"({i}, {j})",
                    "||mu_i - mu_j||": dist,
                    "sigma_bar_i + sigma_bar_j": denom,
                    "r_ij (s=1)": dist / denom,
                }
            )
    return pd.DataFrame(linhas).sort_values("r_ij (s=1)").reset_index(drop=True)


def mixing_rate(X, y, means):
    """Fracao de pontos cujo centro mais proximo nao e o da propria classe."""
    dists = np.linalg.norm(X[:, None, :] - means[None, :, :], axis=2)
    return float(np.mean(dists.argmin(axis=1) != y))


def figure_1(X, y, path):
    plt.figure(figsize=(8, 6))
    for c in range(len(NAMES)):
        m = y == c
        plt.scatter(X[m, 0], X[m, 1], s=14, alpha=0.7, label=NAMES[c])
    plt.scatter(MEAN[:, 0], MEAN[:, 1], marker="X", s=180, c="black",
                zorder=5, label="Class means")
    plt.title("Figure 1 - Four Gaussian clouds ($s = 1$)")
    plt.xlabel("$x_1$")
    plt.ylabel("$x_2$")
    plt.legend(loc="upper left", fontsize=9)
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def figure_2(datasets, path):
    all_pts = np.vstack([X for X, _ in datasets.values()])
    xlim = (all_pts[:, 0].min() - 1, all_pts[:, 0].max() + 1)
    ylim = (all_pts[:, 1].min() - 1, all_pts[:, 1].max() + 1)

    fig, axes = plt.subplots(2, 2, figsize=(12, 9))
    for ax, sc in zip(axes.flat, SCALES):
        X, y = datasets[sc]
        for c in range(len(NAMES)):
            m = y == c
            ax.scatter(X[m, 0], X[m, 1], s=10, alpha=0.6, label=NAMES[c])
        ax.scatter(MEAN[:, 0], MEAN[:, 1], marker="X", s=110, c="black",
                   zorder=5, label="Class means")
        ax.set_title(f"$s = {sc}$")
        ax.set_xlim(xlim)
        ax.set_ylim(ylim)
        ax.set_xlabel("$x_1$")
        ax.set_ylabel("$x_2$")
        ax.legend(loc="upper left", fontsize=8)
    fig.suptitle("Figure 2 - Same means, growing spread (shared axes)",
                 fontsize=15, fontweight="bold")
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def figure_3(mixing, r_min, path):
    fig, ax = plt.subplots(figsize=(8, 5))
    ax.plot(list(mixing.keys()), list(mixing.values()), marker="o",
            linewidth=2, markersize=9, label="mixing rate")
    for sc, v in mixing.items():
        ax.annotate(f"{v:.4f}", (sc, v), textcoords="offset points",
                    xytext=(0, 11), ha="center", fontsize=10)

    ax2 = ax.twinx()
    s_grid = np.linspace(min(SCALES), max(SCALES), 200)
    ax2.plot(s_grid, r_min / s_grid, linestyle="--", color="firebrick",
             linewidth=1.8, label="$r_{min}(s) = r_{min}(1)/s$")
    ax2.axhline(1.0, color="grey", linestyle=":", linewidth=1.2)
    ax2.set_ylabel("$r_{min}$", color="firebrick")
    ax2.grid(False)

    ax.set_title("Figure 3 - Mixing rate vs. scale factor")
    ax.set_xlabel("scale factor $s$")
    ax.set_ylabel("mixing rate")
    handles = ax.get_lines() + ax2.get_lines()[:1]
    ax.legend(handles, [h.get_label() for h in handles], loc="upper left", fontsize=9)
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def figure_1b(X, y, path):
    """Particao por centro mais proximo: esboco das fronteiras do item C.2."""
    xx, yy = np.meshgrid(
        np.linspace(X[:, 0].min() - 1, X[:, 0].max() + 1, 500),
        np.linspace(X[:, 1].min() - 1, X[:, 1].max() + 1, 500),
    )
    grid = np.c_[xx.ravel(), yy.ravel()]
    zz = np.linalg.norm(grid[:, None, :] - MEAN[None, :, :], axis=2).argmin(axis=1)
    zz = zz.reshape(xx.shape)

    plt.figure(figsize=(9, 6.5))
    plt.contourf(xx, yy, zz, levels=np.arange(-0.5, len(MEAN)), alpha=0.15)
    plt.contour(xx, yy, zz, levels=np.arange(-0.5, len(MEAN)),
                colors="black", linewidths=1.2, linestyles="--")
    for c in range(len(NAMES)):
        m = y == c
        plt.scatter(X[m, 0], X[m, 1], s=14, alpha=0.75, label=NAMES[c])
    plt.scatter(MEAN[:, 0], MEAN[:, 1], marker="X", s=170, c="black",
                zorder=5, label="Class means")
    plt.title("Figure 1b - Sketch of the decision boundaries")
    plt.xlabel("$x_1$")
    plt.ylabel("$x_2$")
    plt.legend(loc="upper left", fontsize=9)
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def main():
    X1, y1 = generate_clouds(MEAN, STD, Z, scale=1.0)
    print("A - Figure 1")
    print(f"  X {X1.shape} | pontos por classe {np.bincount(y1)}")
    figure_1(X1, y1, os.path.join(FIG_DIR, "fig1.png"))

    datasets = {sc: generate_clouds(MEAN, STD, Z, scale=sc) for sc in SCALES}
    figure_2(datasets, os.path.join(FIG_DIR, "fig2.png"))

    print("\nB.2 - Separation ratio (s = 1)")
    sep = separation_table(MEAN, STD)
    print(sep.round(4).to_string(index=False))
    par_min = sep.iloc[0]["pair"]
    r_min = float(sep.iloc[0]["r_ij (s=1)"])
    print(f"  menor r_ij: {r_min:.4f} no par {par_min}")
    print(f"  em s = 2 (extrapolado): {r_min / 2:.4f}")

    print("\nB.3 - Mixing rate")
    mixing = {sc: mixing_rate(X, y, MEAN) for sc, (X, y) in datasets.items()}
    for sc in SCALES:
        print(f"  s = {sc:<4} mixing {mixing[sc]:.4f}   r_min(s) = {r_min / sc:.4f}")
    figure_3(mixing, r_min, os.path.join(FIG_DIR, "fig3.png"))

    print("\nC.2 - Figure 1b")
    figure_1b(X1, y1, os.path.join(FIG_DIR, "fig1b.png"))

    print("\nFiguras salvas em", os.path.normpath(FIG_DIR))


if __name__ == "__main__":
    main()
A — Generate the clouds
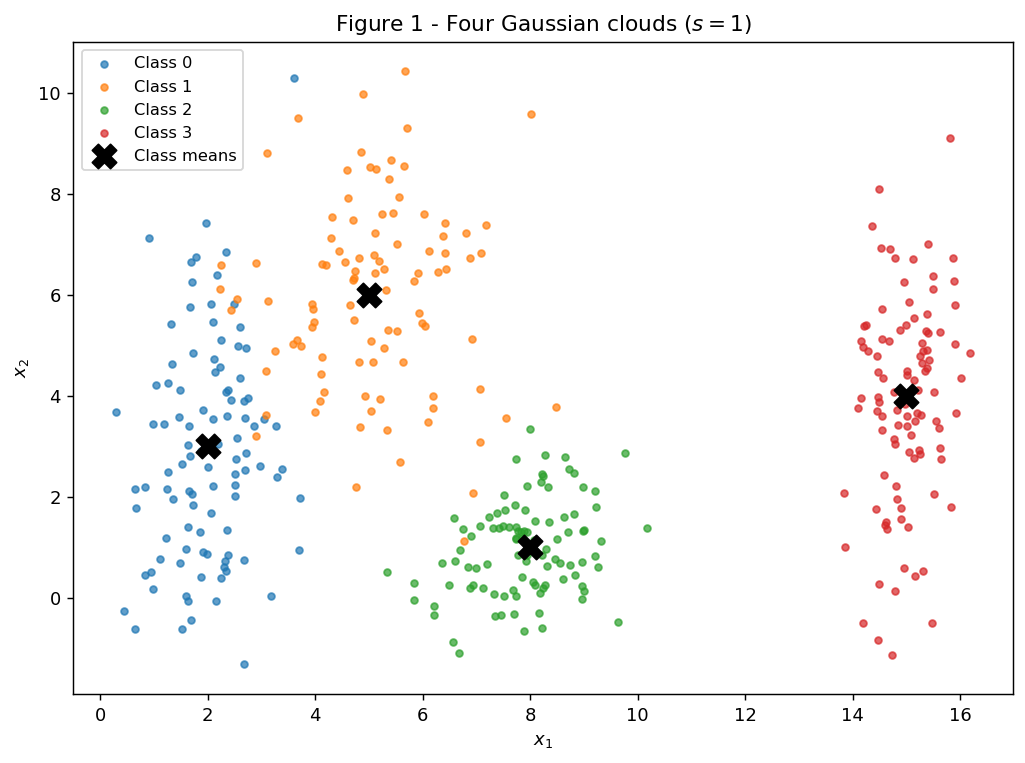
400 amostras, 100 por classe, com as medias e desvios do enunciado. Os centros estao marcados com um X preto.
B — More or less spread out
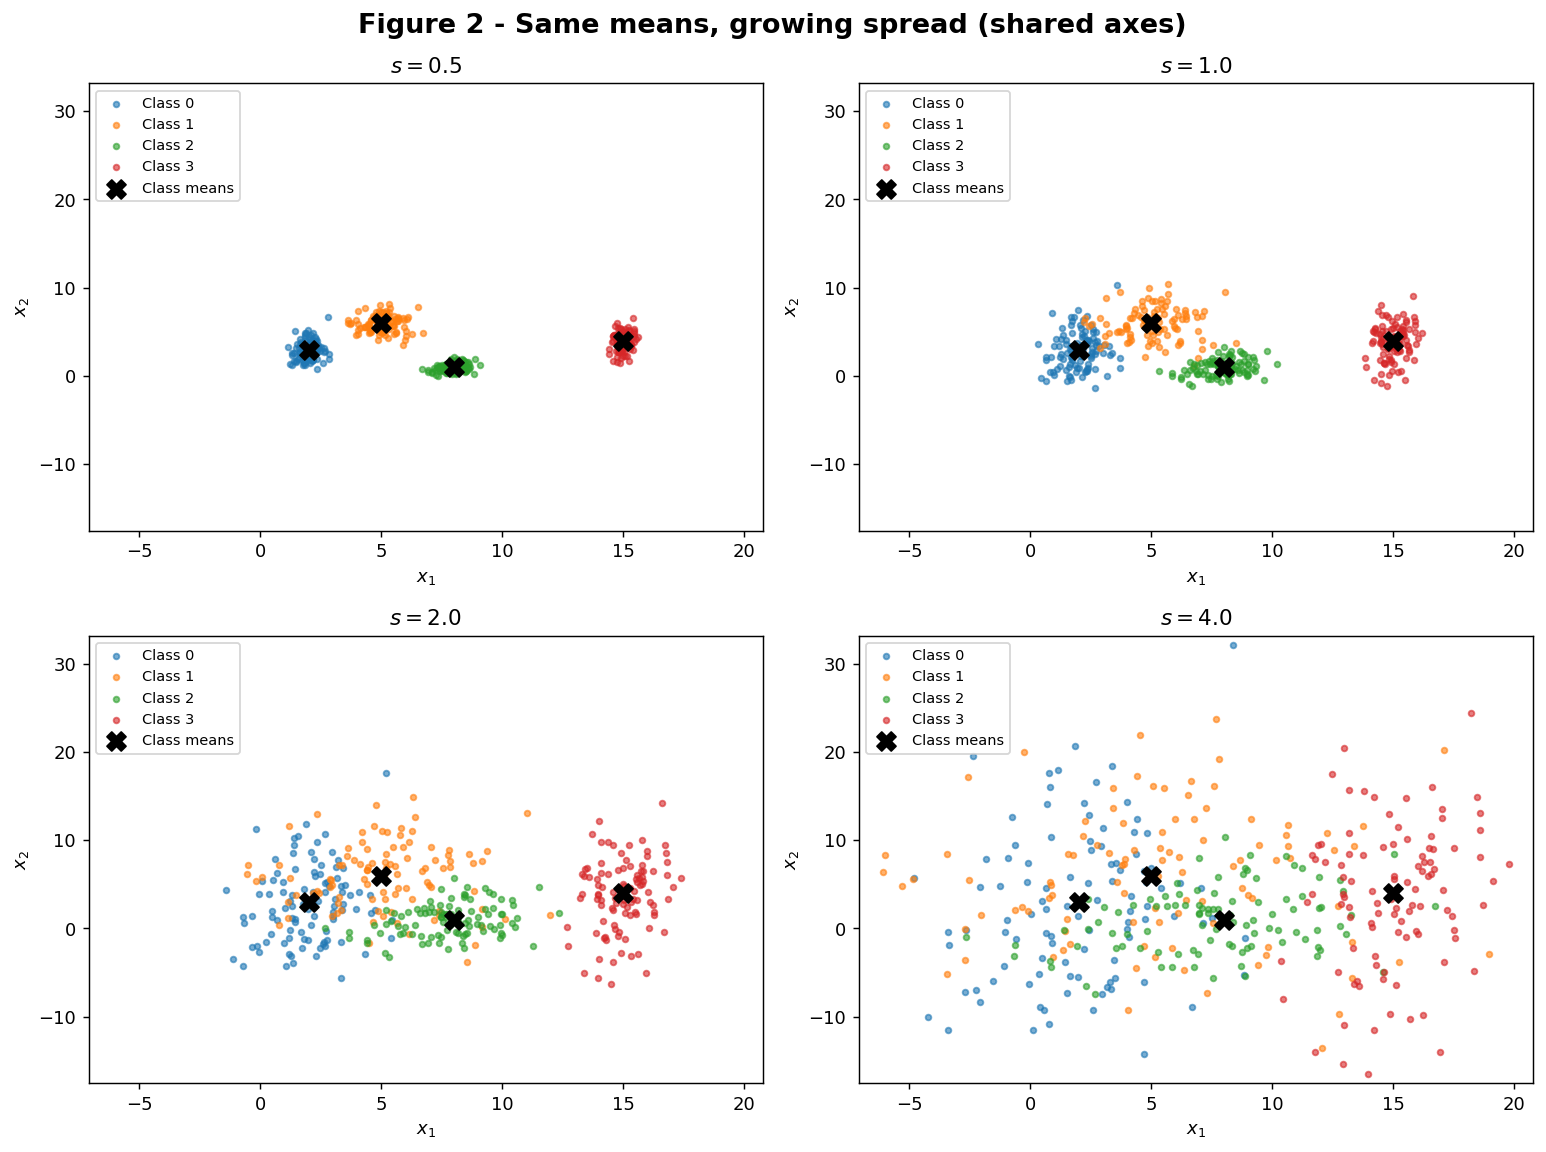
Os quatro datasets sao gerados a partir do mesmo ruido padrao, sorteado uma unica vez, multiplicado por STD * s. Assim os paineis mostram as mesmas nuvens dilatando, e nao quatro sorteios distintos. Os limites dos eixos sao comuns aos quatro paineis.
Separation ratio em s = 1
| par | \(\lVert \mu_i - \mu_j \rVert\) | \(\bar\sigma_i + \bar\sigma_j\) | \(r_{ij}\) (s = 1) |
|---|---|---|---|
| (0, 1) | 4.2426 | 3.20 | 1.3258 |
| (1, 2) | 5.8310 | 2.45 | 2.3800 |
| (0, 2) | 6.3246 | 2.55 | 2.4802 |
| (2, 3) | 7.6158 | 2.15 | 3.5422 |
| (1, 3) | 10.1980 | 2.80 | 3.6422 |
| (0, 3) | 13.0384 | 2.90 | 4.4960 |
O menor e o par (0, 1), com \(r_{01} = 1.3258\). Como as medias nao mudam e todo desvio e multiplicado por \(s\), vale \(r_{ij}(s) = r_{ij}(1)/s\). Em \(s = 2\) o menor \(r_{ij}\) passa a ser 0.6629, sem gerar nenhum dado novo.
Mixing rate
| \(s\) | mixing rate | \(r_{min}\) neste \(s\) |
|---|---|---|
| 0.5 | 0.0025 | 2.6517 |
| 1.0 | 0.0500 | 1.3258 |
| 2.0 | 0.2025 | 0.6629 |
| 4.0 | 0.4300 | 0.3315 |
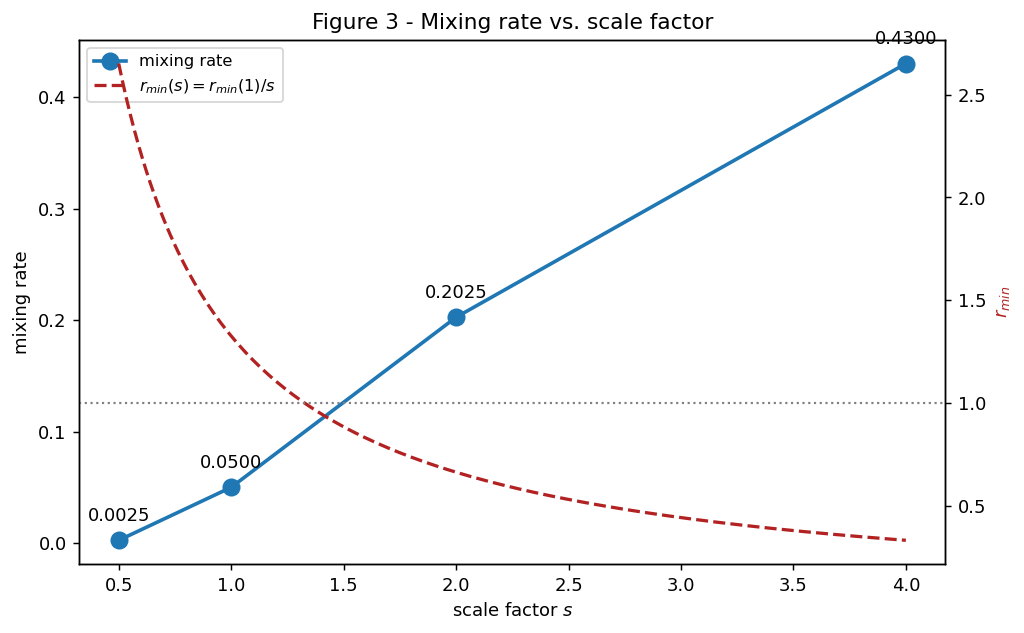
A partir de qual escala as nuvens deixam de ser separaveis por retas? A partir de \(s = 2\). Ate \(s = 1\) a mistura fica em 5%, concentrada numa unica fronteira; em \(s = 2\) ela salta para 20%, ou seja, um em cada cinco pontos ja esta mais perto de um centro que nao e o da sua classe. Esses pontos nao podem ser recuperados por fronteira nenhuma, reta ou curva.
O que acontece com o menor \(r_{ij}\) nesse ponto e a explicacao do fenomeno: ele cai de 1.3258 em \(s = 1\) para 0.6629 em \(s = 2\), cruzando o valor 1. Enquanto \(r_{ij} > 1\) os centros estao mais afastados do que a soma dos espalhamentos e existe um corredor vazio entre as nuvens; abaixo de 1 esse corredor desaparece e as caudas gaussianas passam a ocupar o mesmo espaco. Em \(s = 4\) o menor \(r_{ij}\) ja e 0.3315 e a mistura chega a 43%.
C — Analysis
1. Sobreposicao e separabilidade linear. Em \(s = 1\) as classes se misturam num lugar especifico, nao em geral. Cinco dos seis pares tem \(r_{ij}\) acima de 2.3, ou seja, ficam bem afastados. O unico par apertado e Classe 0 e Classe 1, com \(r_{01} = 1.3258\). A Classe 3 e a mais isolada, em torno de \(x_1 = 15\).
Uma fronteira linear sozinha nao separa as quatro classes. Uma reta divide o plano em dois pedacos e sao necessarias quatro regioes, entao o problema e de contagem, nao de encontrar a reta certa.
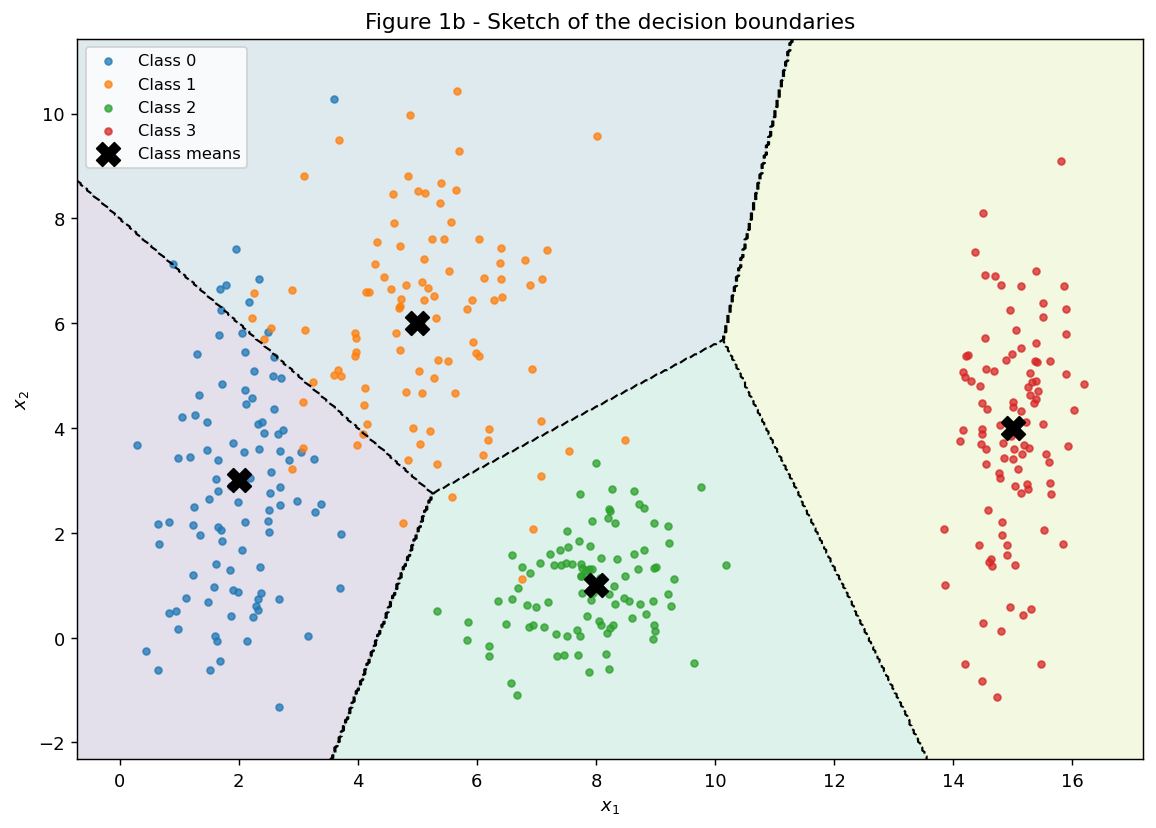
Um conjunto de fronteiras lineares resolve bem. A taxa de mistura em \(s = 1\) e 0.0500, e esse e aproximadamente o erro que uma separacao por retas cometeria. As regioes da Figura 1b sao delimitadas por segmentos retos, e uma rede com uma camada escondida e poucos neuronios reproduz esse formato. Os 5% restantes estao quase todos na fronteira entre a Classe 0 e a Classe 1.
2. Esboco das fronteiras. A Figura 1b mostra a particao por centro mais proximo. As fronteiras ficam no meio do caminho entre cada par de centros vizinhos, perpendiculares a reta que os liga — a posicao que deixa a maior folga possivel para os dois lados quando as nuvens tem espalhamento parecido. Existem pontos onde tres fronteiras se encontram e as tres classes ficam equidistantes; sao os lugares de menor confianca do modelo. Onde os desvios sao anisotropicos a fronteira nao fica exatamente no meio: a Classe 0 tem desvio \([0.8,\ 2.5]\), muito mais espalhada na vertical, o que empurra a fronteira com a Classe 1 lateralmente. Uma rede tambem arredondaria os cantos, ja que ativacoes suaves nao produzem quinas.
3. Relacao com o item B. O que muda entre as escalas e o tamanho da regiao de erro, nao a posicao das fronteiras. Como as medias sao fixas, a particao da Figura 1b vale para todas as escalas — as retas otimas nao dependem de \(s\). Muda apenas quantos pontos caem do lado errado delas.
A imagem util e uma faixa de ambiguidade colada em cada fronteira: a largura dela cresce com o desvio, ou seja com \(s\), enquanto a distancia entre os centros continua igual. E exatamente isso que \(r_{ij}(s) = r_{ij}(1)/s\) mede. O menor \(r_{ij}\) cai de 2.6517 em \(s = 0.5\) para 0.3315 em \(s = 4\), e a taxa de mistura sobe de 0.0025 para 0.4300 no mesmo intervalo.
A consequencia pratica e que, passado certo espalhamento, aumentar a capacidade da rede nao ajuda. Um modelo mais profundo consegue entortar a fronteira para acertar pontos especificos do treino, mas esses pontos vem de distribuicoes que realmente se sobrepoem — a contorcao esta ajustando ruido. O erro de treino cai e o de teste nao, que e overfitting. Vale registrar que a fronteira otima entre duas gaussianas com covariancias parecidas ja e uma reta: no regime de alta sobreposicao nao e a linearidade que limita o desempenho, e a sobreposicao em si.
Exercise 2
Abordagem. Dois datasets, ambos em 5 dimensoes e com 500 amostras por classe, mas construidos sobre principios opostos. O Dataset I separa as classes por posicao (os centros estao deslocados); o Dataset II separa por raio (os centros coincidem, as cascas nao). O contraste mostra que a segunda estrutura e invisivel para qualquer metodo linear, PCA inclusive, e que essa invisibilidade e uma propriedade da geometria e nao falta de dados.
"""Exercise 2 - Non-linearity in higher dimensions.

Gera o Dataset I (gaussianas 5D deslocadas) e o Dataset II (cascas concentricas),
aplica PCA, mede distancia entre centros e raios, e salva as Figuras 4 e 5.

Uso:  python ex2_nonlinearity.py
"""

import os

import numpy as np
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

rng = np.random.default_rng(42)

FIG_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "figures")
os.makedirs(FIG_DIR, exist_ok=True)

DIM = 5
N_5D = 500

MEAN_A = np.array([0.0, 0.0, 0.0, 0.0, 0.0])
MEAN_B = np.array([1.5, 1.5, 1.5, 1.5, 1.5])

# Sigma_A: correlacao positiva entre as features 0 e 1.
COV_A = np.array([
    [1.0, 0.8, 0.1, 0.0, 0.0],
    [0.8, 1.0, 0.3, 0.0, 0.0],
    [0.1, 0.3, 1.0, 0.5, 0.0],
    [0.0, 0.0, 0.5, 1.0, 0.2],
    [0.0, 0.0, 0.0, 0.2, 1.0],
])

# Sigma_B: variancias maiores e correlacao negativa entre as features 0 e 1.
COV_B = np.array([
    [1.5, -0.7, 0.2, 0.0, 0.0],
    [-0.7, 1.5, 0.4, 0.0, 0.0],
    [0.2, 0.4, 1.5, 0.6, 0.0],
    [0.0, 0.0, 0.6, 1.5, 0.3],
    [0.0, 0.0, 0.0, 0.3, 1.5],
])

RADIUS_C = {"mu": 2.0, "sigma": 0.4}
RADIUS_D = {"mu": 5.0, "sigma": 0.4}


def sample_shell(n, dim, mu_r, sigma_r):
    """Direcao uniforme na esfera unitaria, raio ~ Normal(mu_r, sigma_r)."""
    directions = rng.normal(0, 1, size=(n, dim))
    directions /= np.linalg.norm(directions, axis=1, keepdims=True)
    radii = np.clip(rng.normal(mu_r, sigma_r, n), 0, None)
    return directions * radii[:, None]


def centre_distance(X, y):
    """Distancia euclidiana entre os dois centroides, no espaco 5D original."""
    return float(np.linalg.norm(X[y == 0].mean(axis=0) - X[y == 1].mean(axis=0)))


def separate_dataset_ii(X, tau):
    """g(x) = sum(x_i^2) - tau^2; retorna 1 (casca) se g(x) > 0, senao 0."""
    return (np.sum(X ** 2, axis=1) > tau ** 2).astype(int)


def figure_4(P1, y1, evr1, P2, y2, evr2, path):
    fig, axes = plt.subplots(1, 2, figsize=(13, 5.5))
    painels = [
        (axes[0], P1, y1, ("Class A", "Class B"),
         "Dataset I - shifted Gaussians", evr1),
        (axes[1], P2, y2, ("Class C (core)", "Class D (shell)"),
         "Dataset II - concentric shells", evr2),
    ]
    for ax, P, y, nomes, titulo, evr in painels:
        for k, nome in enumerate(nomes):
            m = y == k
            ax.scatter(P[m, 0], P[m, 1], s=14, alpha=0.55, label=nome)
        ax.set_title(f"{titulo}\nPC1+PC2 = {evr.sum():.1%} da variancia")
        ax.set_xlabel(f"PC1 ({evr[0]:.1%})")
        ax.set_ylabel(f"PC2 ({evr[1]:.1%})")
        ax.legend(fontsize=9)
        ax.set_aspect("equal", adjustable="datalim")
    fig.suptitle("Figure 4 - PCA projection of both 5D datasets",
                 fontsize=15, fontweight="bold")
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def figure_5(r_ds1, r_ds2, path):
    fig, axes = plt.subplots(1, 2, figsize=(13, 5))
    for ax, radii, titulo in [(axes[0], r_ds1, "Dataset I"),
                              (axes[1], r_ds2, "Dataset II")]:
        for nome, r in radii.items():
            ax.hist(r, bins=40, alpha=0.6, edgecolor="white",
                    label=f"{nome} (mean {r.mean():.2f})")
        ax.set_title(f"{titulo} - radius $\\|x\\|$")
        ax.set_xlabel("$\\|x\\|$")
        ax.set_ylabel("count")
        ax.legend(fontsize=9)
    fig.suptitle("Figure 5 - Radius histogram, both classes overlaid",
                 fontsize=15, fontweight="bold")
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def main():
    XA = rng.multivariate_normal(MEAN_A, COV_A, N_5D)
    XB = rng.multivariate_normal(MEAN_B, COV_B, N_5D)
    X_ds1 = np.vstack([XA, XB])
    y_ds1 = np.concatenate([np.zeros(N_5D, dtype=int), np.ones(N_5D, dtype=int)])

    print("A - Dataset I", X_ds1.shape)
    print("  media A:", XA.mean(axis=0).round(3))
    print("  media B:", XB.mean(axis=0).round(3))
    print(f"  corr A(0,1): {np.corrcoef(XA[:, 0], XA[:, 1])[0, 1]:+.3f}  (positiva)")
    print(f"  corr B(0,1): {np.corrcoef(XB[:, 0], XB[:, 1])[0, 1]:+.3f}  (negativa)")

    XC = sample_shell(N_5D, DIM, RADIUS_C["mu"], RADIUS_C["sigma"])
    XD = sample_shell(N_5D, DIM, RADIUS_D["mu"], RADIUS_D["sigma"])
    X_ds2 = np.vstack([XC, XD])
    y_ds2 = np.concatenate([np.zeros(N_5D, dtype=int), np.ones(N_5D, dtype=int)])

    print("\nB - Dataset II", X_ds2.shape)
    print(f"  raio medio C: {np.linalg.norm(XC, axis=1).mean():.3f}")
    print(f"  raio medio D: {np.linalg.norm(XD, axis=1).mean():.3f}")
    print("  centro C:", XC.mean(axis=0).round(3))
    print("  centro D:", XD.mean(axis=0).round(3))

    pca1, pca2 = PCA(n_components=2), PCA(n_components=2)
    P1 = pca1.fit_transform(X_ds1)
    P2 = pca2.fit_transform(X_ds2)
    evr1 = pca1.explained_variance_ratio_
    evr2 = pca2.explained_variance_ratio_
    figure_4(P1, y_ds1, evr1, P2, y_ds2, evr2, os.path.join(FIG_DIR, "fig4.png"))

    print("\nC.1 / C.2 - Explained variance")
    print(f"  Dataset I : PC1 {evr1[0]:.4f} + PC2 {evr1[1]:.4f} = {evr1.sum():.4f}")
    print(f"  Dataset II: PC1 {evr2[0]:.4f} + PC2 {evr2[1]:.4f} = {evr2.sum():.4f}")

    print("\nC.3 - Distancia entre centros (5D)")
    print(f"  Dataset I : {centre_distance(X_ds1, y_ds1):.4f}")
    print(f"  Dataset II: {centre_distance(X_ds2, y_ds2):.4f}")

    r_ds1 = {"Class A": np.linalg.norm(XA, axis=1),
             "Class B": np.linalg.norm(XB, axis=1)}
    r_ds2 = {"Class C (core)": np.linalg.norm(XC, axis=1),
             "Class D (shell)": np.linalg.norm(XD, axis=1)}
    figure_5(r_ds1, r_ds2, os.path.join(FIG_DIR, "fig5.png"))

    tau = (RADIUS_C["mu"] + RADIUS_D["mu"]) / 2
    pred = separate_dataset_ii(X_ds2, tau)
    print("\nD.3 - Funcao separadora")
    print(f"  tau = {tau:.1f} (meio do caminho entre os raios do enunciado)")
    print(f"  fracao correta: {np.mean(pred == y_ds2):.4f}")

    print("\nFiguras salvas em", os.path.normpath(FIG_DIR))


if __name__ == "__main__":
    main()
A — Dataset I: shifted Gaussians
Gerado com rng.multivariate_normal, que ja embute a correlacao das matrizes de covariancia. As correlacoes empiricas entre as features 0 e 1 saem +0.778 para a classe A e −0.518 para a classe B, com os sinais esperados. O valor da classe B nao bate com o \(-0.7\) da matriz porque covariancia e correlacao sao grandezas diferentes: \(-0.7 / \sqrt{1.5 \times 1.5} = -0.467\). So coincidem quando a variancia e 1, que e o caso da classe A.
B — Dataset II: concentric shells
As direcoes vem de um sorteio gaussiano normalizado, o que da distribuicao uniforme na esfera unitaria de \(\mathbb{R}^5\) (a normal multivariada padrao e rotacionalmente simetrica). Os raios medios saem em 1.972 para a classe C e 5.005 para a classe D, contra os alvos 2.0 e 5.0.
C — Visualize and compare
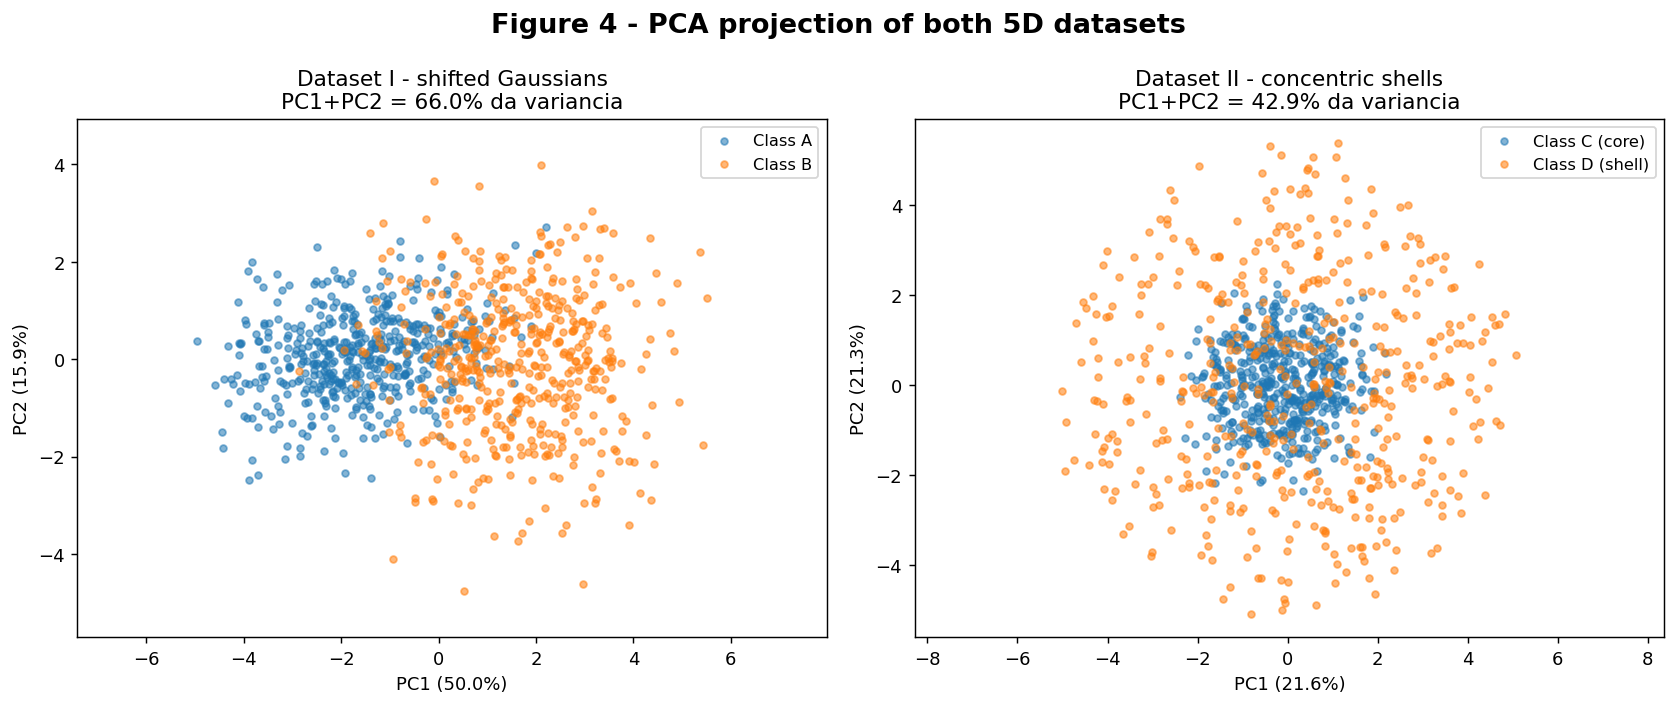
Variancia explicada. Dataset I: PC1 0.5004 + PC2 0.1593 = 0.6597. Dataset II: PC1 0.2159 + PC2 0.2132 = 0.4291.
Em qual dataset a projecao 2D preserva melhor a informacao relevante? No Dataset I, com folga. Ali as duas classes tem centros diferentes, entao existe uma direcao no espaco apontando de uma nuvem para a outra. Essa direcao concentra bastante variancia justamente porque as classes estao em pontas opostas dela, e como a PCA procura a direcao de maior variancia, acaba encontrando exatamente essa.
No Dataset II nao existe direcao que funcione. As duas cascas dividem o mesmo centro, entao qualquer plano de projecao mostra a bola de dentro sobreposta ao anel de fora — a sombra de uma casca oca e um disco cheio, nao um anel. O ponto decisivo e que o Dataset II tem variancia explicada menor e mesmo assim e o dataset perfeitamente separavel, como o item D mostra. Variancia explicada e separabilidade sao objetivos diferentes.
Distancia entre os centros (5D). Dataset I: 3.2282, proximo da referencia teorica \(\lVert \mu_B - \mu_A \rVert = 3.3541\). Dataset II: 0.2662, ruido amostral em torno de zero, como esperado de duas distribuicoes que compartilham o centro.
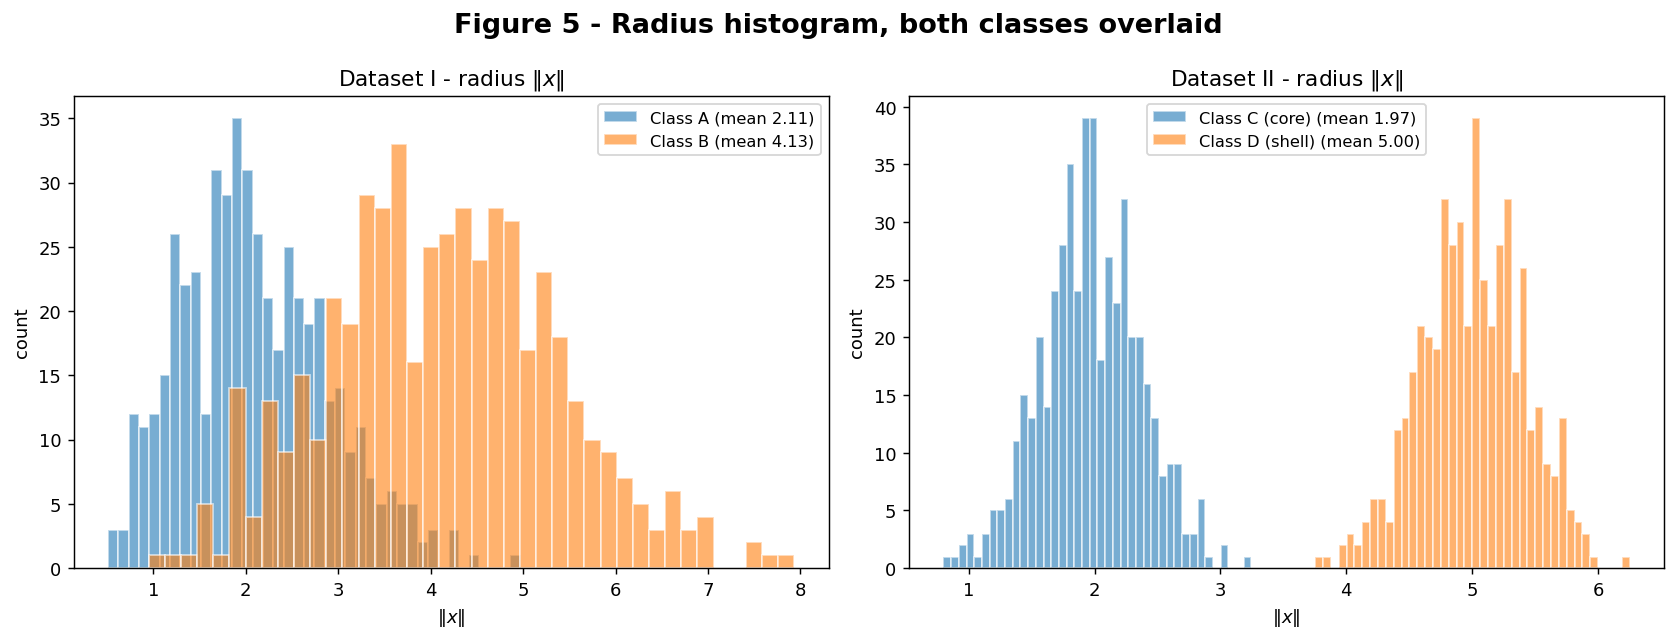
Os histogramas de raio invertem o quadro. No Dataset II as medias sao 1.97 e 5.01, com desvio 0.4 cada — mais de sete desvios de separacao, sem sobreposicao alguma. No Dataset I as distribuicoes sao largas e se sobrepoem, porque ali o raio nao e a variavel informativa.
D — Analysis
1. Centros coincidentes e histogramas separados. A distancia entre os centros do Dataset II e 0.2662, praticamente zero, enquanto os histogramas de raio estao bem separados. A combinacao mostra que as classes sao separaveis, mas nao por um hiperplano.
Um classificador linear so enxerga a projecao dos pontos sobre uma direcao. Como as duas cascas sao simetricas em torno do mesmo centro, qualquer direcao escolhida projeta as duas classes uma sobre a outra, sempre centradas em zero. Qualquer reta acerta em torno de metade dos pontos. O raio, por outro lado, separa perfeitamente. A informacao esta inteira nos dados, apenas nao numa forma que um modelo linear consiga usar.
2. Por que mais dados nao resolvem. O problema nao e falta de amostra, e sim o tipo de fronteira que o modelo consegue desenhar. Uma fronteira linear em 5 dimensoes divide o espaco em dois pedacos, e cada pedaco se estende infinitamente em alguma direcao. A regiao correta aqui e uma casca esferica, que nao tem esse formato. Qualquer fronteira linear erra, e erra igual com mil ou com um milhao de pontos.
De forma concreta: uma fronteira que englobe toda a classe C, que esta perto da origem, tambem engloba todos os pontos da classe D que estao do mesmo lado — e D esta espalhada em todas as direcoes. Nao existe onde colocar a reta. O que resolve e transformar as features. Trocando os cinco valores de \(x\) por \(\lVert x \rVert\), o problema vira unidimensional e um limiar resolve. E isso que as camadas escondidas de uma rede fazem: constroem features novas antes da parte linear.
3. Uma projecao PCA misturada prova inseparabilidade? Nao, e o Dataset II e o proprio contraexemplo. A PCA e linear — so rotaciona e descarta direcoes. Quando o grafico dela mostra as classes misturadas, a unica conclusao possivel e que nenhuma projecao linear em 2D separa. Nada e dito sobre funcoes nao lineares.
A evidencia esta nos resultados acima: o painel direito da Figura 4 mostra as classes C e D embaralhadas, e ainda assim um corte unico em \(\lVert x \rVert\) acerta 1.0000 dos pontos. Reforca o argumento o fato de o Dataset II ter variancia explicada menor (0.4291 contra 0.6597 do Dataset I) e mesmo assim ser o dataset separavel.
A assimetria vale ser registrada: um grafico de PCA com classes bem separadas e evidencia positiva forte, porque exibe um separador linear concreto. Um grafico com classes misturadas e evidencia negativa fraca, porque descarta apenas a separabilidade linear naquela projecao.
Funcao que separa o Dataset II:
Classifica como casca D quando \(g(x) > 0\) e como nucleo C quando \(g(x) \le 0\). Com \(\tau = 3.5\), o meio do caminho entre os raios 2.0 e 5.0 do enunciado, o resultado e 1.0000 dos pontos do lado correto. O valor de \(\tau\) vem dos parametros e nao de um ajuste aos dados. A soma dos quadrados foi usada em vez da raiz porque a raiz e monotona e nao altera a ordenacao, e porque e a forma sugerida pelo enunciado. Note que \(g\) e quadratica nos inputs — exatamente o tipo de funcao que um modelo linear nao expressa.
Exercise 3
Abordagem. A ativacao alvo e a tanh, que satura fora de aproximadamente \([-2, 2]\) — alem disso o gradiente e numericamente zero e a unidade para de aprender. Todo o pipeline tem entao um objetivo: entregar features numa escala limitada e comparavel, sem NaN e sem caudas extremas. Toda transformacao e ajustada apenas no conjunto de treino e aplicada aos dois.
"""Exercise 3 - Preparing real-world data for a neural network.

Pre-processa o Spaceship Titanic (train.csv) para uma rede com ativacao tanh:
imputacao, one-hot, TotalSpend, log(1+x) e escala para [-1, 1]. Salva a Figura 6
e imprime todos os numeros da Results summary.

O arquivo train.csv deve estar em docs/exercises/data/dataset/train.csv
(baixe em https://www.kaggle.com/competitions/spaceship-titanic/data).

Uso:  python ex3_preprocessing.py
"""

import os

import numpy as np
import pandas as pd
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder, MinMaxScaler

rng = np.random.default_rng(42)
SEED = 42

HERE = os.path.dirname(os.path.abspath(__file__))
FIG_DIR = os.path.join(HERE, "..", "figures")
CSV_PATH = os.path.join(HERE, "..", "dataset", "train.csv")
os.makedirs(FIG_DIR, exist_ok=True)

SPEND_COLS = ["RoomService", "FoodCourt", "ShoppingMall", "Spa", "VRDeck"]
NUM_COLS = ["Age"] + SPEND_COLS
CAT_COLS = ["HomePlanet", "CryoSleep", "Destination", "VIP"]
DROP_COLS = ["PassengerId", "Name", "Cabin"]
TARGET = "Transported"


def describe(df):
    """Item A: alvo, balanco, tipos, faltantes e estatisticas de gasto."""
    print("A.2 - Balanco de classes")
    for k, v in df[TARGET].value_counts(normalize=True).sort_index().items():
        print(f"  {str(k):<6} {v:.4f}  ({int(v * len(df))} passageiros)")

    print("\nA.3 - Tipos de feature")
    print(f"  numericas   ({len(NUM_COLS)}): {NUM_COLS}")
    print(f"  categoricas ({len(CAT_COLS)}): {CAT_COLS}")
    print(f"  descartadas ({len(DROP_COLS)}): {DROP_COLS}")

    print("\nA.4 - Valores faltantes")
    missing = pd.DataFrame({
        "faltantes": df.isna().sum(),
        "pct": (100 * df.isna().mean()).round(2),
    }).sort_values("faltantes", ascending=False)
    print(missing.to_string())
    print(f"  linhas com ao menos um NaN: {df.isna().any(axis=1).sum()} "
          f"({100 * df.isna().any(axis=1).mean():.1f}%)")

    print("\nA.5 - Colunas de gasto")
    stats = df[SPEND_COLS].agg(["mean", "median", "max", "std"]).T
    stats["pct_zero"] = [100 * (df[c] == 0).mean() for c in SPEND_COLS]
    print(stats.round(2).to_string())
    return missing, stats


def figure_6(raw_fc, scaled_fc, path):
    fig, axes = plt.subplots(1, 2, figsize=(13, 4.8))

    axes[0].hist(raw_fc, bins=60, edgecolor="white", label="FoodCourt (raw)")
    axes[0].set_title("FoodCourt - before preprocessing")
    axes[0].set_xlabel("credits spent")
    axes[0].set_ylabel("count (log scale)")
    axes[0].set_yscale("log")
    axes[0].legend(fontsize=9)
    axes[0].annotate(f"max = {raw_fc.max():,.0f}", xy=(0.55, 0.85),
                     xycoords="axes fraction", fontsize=11)

    axes[1].hist(scaled_fc, bins=60, edgecolor="white", color="seagreen",
                 label="FoodCourt (processed)")
    axes[1].set_title("FoodCourt - after log1p + MinMax to $[-1, 1]$")
    axes[1].set_xlabel("scaled value")
    axes[1].set_ylabel("count")
    axes[1].axvline(-1, color="grey", linestyle=":")
    axes[1].axvline(1, color="grey", linestyle=":")
    axes[1].legend(fontsize=9)

    fig.suptitle("Figure 6 - Effect of preprocessing on a heavy-tailed feature",
                 fontsize=15, fontweight="bold")
    plt.tight_layout()
    plt.savefig(path, dpi=130, bbox_inches="tight")
    plt.close()


def main():
    if not os.path.exists(CSV_PATH):
        raise FileNotFoundError(
            f"train.csv nao encontrado em {os.path.normpath(CSV_PATH)}. "
            "Baixe o Spaceship Titanic no Kaggle e coloque o arquivo la."
        )

    df = pd.read_csv(CSV_PATH)
    print(f"{df.shape[0]} linhas x {df.shape[1]} colunas\n")
    describe(df)

    # ---- B: split antes de qualquer estatistica
    X_raw = df.drop(columns=DROP_COLS + [TARGET])
    y_raw = df[TARGET].astype(int)
    X_tr_raw, X_te_raw, y_tr, y_te = train_test_split(
        X_raw, y_raw, test_size=0.20, stratify=y_raw, random_state=SEED
    )
    print("\nB - Split 80/20 estratificado")
    print(f"  treino {X_tr_raw.shape}  taxa positiva {y_tr.mean():.4f}")
    print(f"  teste  {X_te_raw.shape}  taxa positiva {y_te.mean():.4f}")
    fc_mean = float(X_tr_raw["FoodCourt"].mean())
    fc_median = float(X_tr_raw["FoodCourt"].median())
    print(f"  FoodCourt no treino, antes de transformar: "
          f"media {fc_mean:.4f} | mediana {fc_median:.4f}")

    # ---- C.1: imputacao, ajustada somente no treino
    num_imputer = SimpleImputer(strategy="median")
    cat_imputer = SimpleImputer(strategy="most_frequent")
    num_imputer.fit(X_tr_raw[NUM_COLS])
    cat_imputer.fit(X_tr_raw[CAT_COLS].astype(object))

    def impute(X):
        out = X.copy()
        out[NUM_COLS] = num_imputer.transform(X[NUM_COLS])
        out[CAT_COLS] = cat_imputer.transform(X[CAT_COLS].astype(object))
        return out

    X_tr, X_te = impute(X_tr_raw), impute(X_te_raw)
    print("\nC.1 - Imputacao (valores aprendidos no treino)")
    for c, v in zip(NUM_COLS, num_imputer.statistics_):
        print(f"  {c:<14} mediana -> {v}")
    for c, v in zip(CAT_COLS, cat_imputer.statistics_):
        print(f"  {c:<14} moda    -> {v}")

    # ---- C.2: one-hot; handle_unknown='ignore' cobre categoria so no teste
    ohe = OneHotEncoder(handle_unknown="ignore", sparse_output=False)
    ohe.fit(X_tr[CAT_COLS].astype(str))
    ohe_names = list(ohe.get_feature_names_out(CAT_COLS))
    tr_cat = pd.DataFrame(ohe.transform(X_tr[CAT_COLS].astype(str)),
                          columns=ohe_names, index=X_tr.index)
    te_cat = pd.DataFrame(ohe.transform(X_te[CAT_COLS].astype(str)),
                          columns=ohe_names, index=X_te.index)
    print(f"\nC.2 - One-hot: {len(CAT_COLS)} colunas -> {len(ohe_names)} indicadoras")
    demo = X_te[CAT_COLS].astype(str).head(1).copy()
    demo.iloc[0, 0] = "Pluto"
    n_hp = sum(n.startswith("HomePlanet") for n in ohe_names)
    print(f"  categoria inedita 'Pluto' -> soma do bloco HomePlanet = "
          f"{ohe.transform(demo)[0][:n_hp].sum():.0f}")

    # ---- C.3: TotalSpend
    for X in (X_tr, X_te):
        X["TotalSpend"] = X[SPEND_COLS].sum(axis=1)
    engineered = SPEND_COLS + ["TotalSpend"]

    # ---- C.4: log(1 + x)
    raw_fc = X_tr["FoodCourt"].copy()
    skew_antes = raw_fc.skew()
    for X in (X_tr, X_te):
        for c in engineered:
            X[c] = np.log1p(X[c])
    print(f"\nC.4 - log1p: assimetria de FoodCourt {skew_antes:.3f} -> "
          f"{X_tr['FoodCourt'].skew():.3f}")

    # ---- C.5: escala para [-1, 1]
    numeric_final = ["Age"] + engineered
    scaler = MinMaxScaler(feature_range=(-1, 1))
    scaler.fit(X_tr[numeric_final])
    tr_num = pd.DataFrame(scaler.transform(X_tr[numeric_final]),
                          columns=numeric_final, index=X_tr.index)
    te_num = pd.DataFrame(scaler.transform(X_te[numeric_final]),
                          columns=numeric_final, index=X_te.index)
    X_train_final = pd.concat([tr_num, tr_cat], axis=1)
    X_test_final = pd.concat([te_num, te_cat], axis=1)

    tr_min, tr_max = X_train_final.values.min(), X_train_final.values.max()
    te_min, te_max = X_test_final.values.min(), X_test_final.values.max()
    print(f"\nC.5 - Escala: treino [{tr_min:.4f}, {tr_max:.4f}] | "
          f"teste [{te_min:.4f}, {te_max:.4f}]")

    # ---- D
    figure_6(raw_fc, X_train_final["FoodCourt"], os.path.join(FIG_DIR, "fig6.png"))

    checks = {
        "sem NaN no treino": int(X_train_final.isna().sum().sum()) == 0,
        "sem NaN no teste": int(X_test_final.isna().sum().sum()) == 0,
        "mesmas colunas nos dois": list(X_train_final.columns) == list(X_test_final.columns),
        "valores finitos": bool(np.isfinite(X_train_final.values).all()
                                and np.isfinite(X_test_final.values).all()),
        "treino em [-1, 1]": tr_min >= -1.0001 and tr_max <= 1.0001,
        "teste compativel com tanh": max(abs(te_min), abs(te_max)) < 2.0,
    }
    print("\nD.2 - Checagens finais")
    for nome, ok in checks.items():
        print(f"  [{'OK' if ok else 'FALHOU'}] {nome}")
    print(f"  shape treino: {X_train_final.shape}")
    print(f"  shape teste:  {X_test_final.shape}")

    print("\n=== Valores para a Results summary ===")
    print(f"  10 - share positiva em Transported: {df[TARGET].mean():.4f}")
    print(f"  11 - FoodCourt no treino: media {fc_mean:.4f} | mediana {fc_median:.4f}")
    print(f"  12 - shape do treino: {X_train_final.shape}")
    print(f"  13 - treino [{tr_min:.4f}, {tr_max:.4f}] | teste [{te_min:.4f}, {te_max:.4f}]")


if __name__ == "__main__":
    main()
A — Get to know the data
Objetivo do dataset. A coluna Transported indica se o passageiro foi transportado para uma dimensao alternativa apos a colisao da nave com a anomalia espaco-temporal. E booleana e e o alvo da classificacao. O balanco entre as duas classes fica praticamente em 50/50, entao acuracia e metrica justa e nao ha necessidade de reponderacao ou reamostragem.
Tipos de feature. Seis numericas (Age e as cinco colunas de gasto), quatro categoricas (HomePlanet, CryoSleep, Destination, VIP) e tres descartadas (PassengerId, Name, Cabin) por serem identificadores ou texto livre. CryoSleep e VIP sao booleanas, mas como tem valores faltantes o pandas as guarda como object; ficam tratadas como categoricas.
Faltantes. Nenhuma coluna esta gravemente danificada — todas ficam em torno de 2% —, mas os buracos estao espalhados por linhas diferentes, de modo que descartar linhas incompletas eliminaria uma fatia grande do dataset. Imputar e a escolha melhor. Das 8693 linhas, 2087 (24.0%) tem ao menos um campo vazio.
| coluna | faltantes | % |
|---|---|---|
CryoSleep | 217 | 2.50 |
ShoppingMall | 208 | 2.39 |
VIP | 203 | 2.34 |
HomePlanet | 201 | 2.31 |
Name | 200 | 2.30 |
Cabin | 199 | 2.29 |
VRDeck | 188 | 2.16 |
Spa | 183 | 2.11 |
FoodCourt | 183 | 2.11 |
Destination | 182 | 2.09 |
RoomService | 181 | 2.08 |
Age | 179 | 2.06 |
PassengerId | 0 | 0.00 |
Transported | 0 | 0.00 |
Media x mediana dos gastos.
| coluna | media | mediana | maximo | desvio | % zeros |
|---|---|---|---|---|---|
RoomService | 224.69 | 0.0 | 14327.0 | 666.72 | 64.16 |
FoodCourt | 458.08 | 0.0 | 29813.0 | 1611.49 | 62.76 |
ShoppingMall | 173.73 | 0.0 | 23492.0 | 604.70 | 64.27 |
Spa | 311.14 | 0.0 | 22408.0 | 1136.71 | 61.24 |
VRDeck | 304.85 | 0.0 | 24133.0 | 1145.72 | 63.21 |
A mediana das cinco colunas e 0 enquanto as medias ficam na casa das centenas e os maximos na casa das dezenas de milhares. Tres leituras decorrem disso. Primeiro, a maioria dos passageiros nao gastou nada — em boa parte sao os passageiros em criosono, que nao tem como consumir. Segundo, as distribuicoes sao fortemente assimetricas a direita: media muito acima da mediana e a assinatura classica, e o desvio padrao fica inflado junto. Terceiro, valores crus nessa escala sao incompativeis com tanh — uma entrada na casa dos milhares satura a unidade instantaneamente, com derivada zero, e o neuronio morre antes do primeiro passo de gradiente.
B — Split before you transform
Split 80/20 estratificado pelo alvo, com random_state=42, feito antes de qualquer estatistica.
Toda estatistica usada nas transformacoes e informacao extraida dos dados: a mediana que preenche uma idade faltante, o minimo e o maximo que reescalam uma coluna, a lista de categorias conhecida pelo encoder. Calcula-las no dataset inteiro e separar depois faz com que as linhas de teste influenciem como as de treino sao transformadas, e o teste deixa de ser um conjunto nao visto. O efeito nao e apenas conceitual: a nota de teste fica otimista e para de indicar como o modelo se comportaria com passageiros novos. Como estimar isso e o motivo de existir um conjunto de teste, vazar informacao para dentro dele anula o proposito da separacao.
A regra seguida daqui em diante e fit no treino e transform nos dois conjuntos.
C — Preprocess
1. Missing data. Numericas com mediana, porque as colunas de gasto tem cauda longa e a media seria puxada pelos poucos valores altissimos, preenchendo os faltantes com um numero que nao representa quase ninguem. Categoricas com a moda, ja que com cerca de 2% de faltantes por coluna a categoria mais frequente adiciona pouco ruido. Os dois imputadores sao ajustados somente no treino.
2. Categorical features. One-hot com handle_unknown='ignore'. Se aparecer uma categoria no teste que nao estava no treino, o encoder coloca zero em todas as colunas daquele grupo em vez de levantar erro, e a linha mantem a largura correta. O script demonstra isso injetando "Pluto" em HomePlanet numa linha de teste: a soma do bloco daquela linha fica em 0. Com handle_unknown='error' o codigo quebraria no primeiro valor inedito, o que e ruim porque em producao nao se controla o que chega.
3. Feature engineering. TotalSpend e a soma das cinco colunas de gasto. Carrega um sinal que nenhuma coluna isolada tem: se o passageiro consumiu alguma coisa, o que serve de proxy para o estado de criosono. Cabin, Name e PassengerId sao descartadas.
4. Heavy tails. A tanh e praticamente linear perto de zero e plana fora de aproximadamente \([-2, 2]\), com derivada \(1 - \tanh^2(z)\) que tende a zero conforme \(|z|\) cresce. Um valor de gasto na casa dos milhares satura a unidade: a saida trava em \(\pm 1\), o gradiente e numericamente nulo e a retropropagacao nao passa sinal. O neuronio fica morto durante todo o treino.
So reescalar nao resolve. Padronizando uma coluna em que a maior parte da massa esta no zero e alguns pontos estao em dezenas de milhares, quase todos os dados caem numa fatia estreita onde a funcao nao discrimina, e os outliers continuam saturando. O problema e a forma da distribuicao, e so uma transformacao nao linear muda forma.
O \(\log(1+x)\) comprime a cauda de modo multiplicativo — a diferenca entre 100 e 1.000 creditos passa a valer o mesmo que entre 1.000 e 10.000. Foi escolhido em vez de \(\log(x)\) porque a maioria dos valores e exatamente zero e \(\log(0)\) e \(-\infty\); o log1p leva 0 em 0, entao o grupo "nao gastou nada" continua sendo um valor unico.
5. Scaling. A escolha foi Normalization para \([-1, 1]\). Como a tanh devolve valores nesse intervalo, manter a entrada na mesma faixa evita que qualquer valor sature a primeira camada logo no inicio. A Standardization deixaria o intervalo aberto e um valor extremo ainda poderia virar um z-score alto o bastante para saturar. A desvantagem do MinMax e a sensibilidade ao minimo e maximo do treino, contornada aplicando-o depois do \(\log(1+x)\), com a cauda ja comprimida. Os valores minimo e maximo resultantes estao na linha 13 da Results summary.
D — Verify and visualize
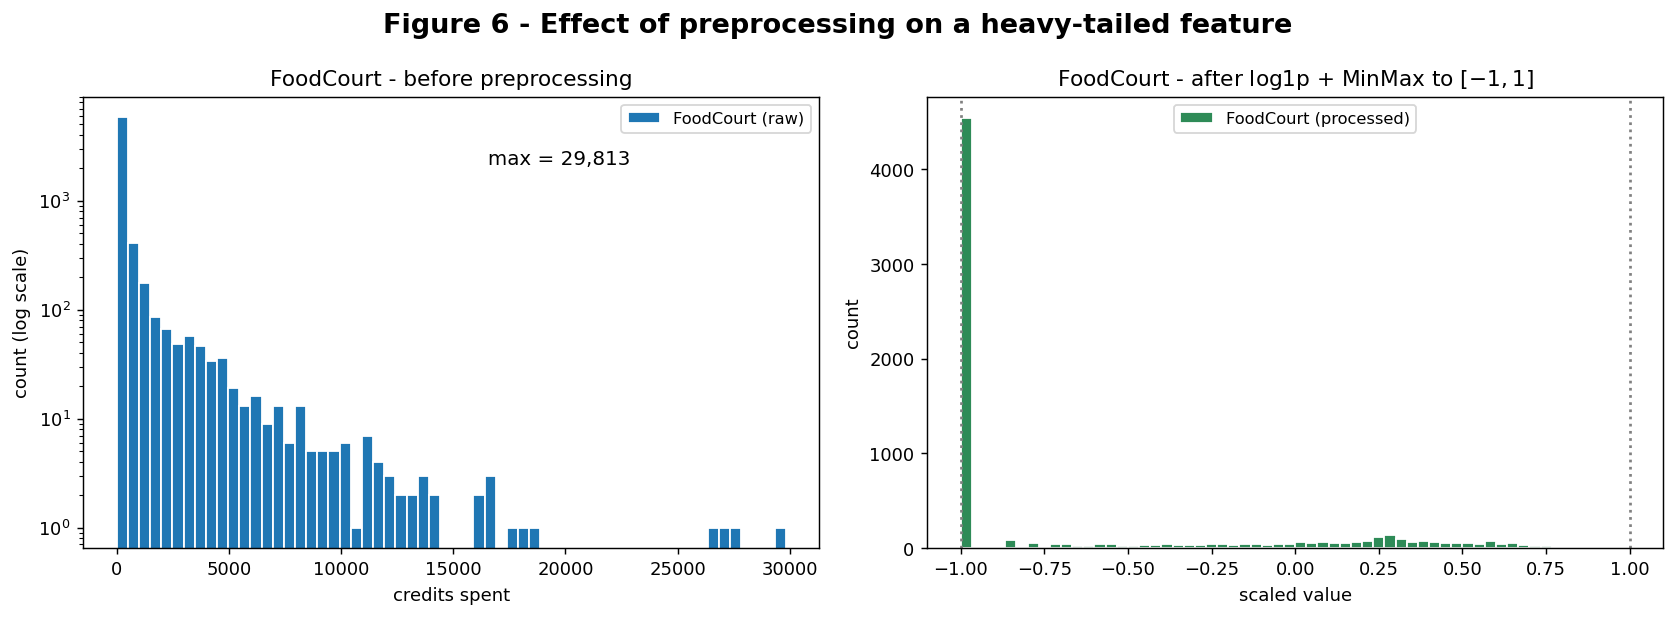
O eixo y do painel esquerdo esta em escala logaritmica; sem isso a barra dos zeros domina o grafico e o resto da distribuicao desaparece. Antes, os valores vao de 0 ao maximo impresso na figura, com quase toda a massa empilhada no zero. Depois do \(\log(1+x)\) e do MinMax, a coluna fica entre \(-1\) e \(1\), com o pico em \(-1\) correspondendo aos passageiros que nao gastaram nada e o restante distribuido ao longo do intervalo.
Checagens finais. O script reporta explicitamente: nenhum NaN nos dois conjuntos, colunas identicas entre treino e teste, todos os valores finitos, treino dentro de \([-1, 1]\) e teste dentro de faixa compativel com tanh. O shape final e o intervalo de valores estao nas linhas 12 e 13 da Results summary. O treino atinge exatamente \(-1\) e \(1\) porque e assim que o MinMax funciona; o teste pode ultrapassar ligeiramente quando algum valor la e maior que o maximo visto no treino — comportamento esperado e correto, ja que cortar o teste para caber no intervalo seria vazamento.
Qual decisao mais afetaria o treino. O \(\log(1+x)\) nas colunas de gasto. As demais escolhas sao refinamentos; essa e a que decide se a rede treina ou nao. Essas cinco colunas sao as mais informativas do dataset, porque gasto esta fortemente ligado ao estado de criosono, que por sua vez esta ligado ao alvo. Sao tambem as de maior faixa dinamica. Sem o \(\log(1+x)\), qualquer reescala linear preserva a forma da distribuicao: quase todos os passageiros ficam espremidos num intervalo minusculo onde a tanh nao os distingue, e os poucos valores altos ficam saturados com gradiente zero. As features mais informativas chegariam a rede no formato menos aproveitavel. Em segundo lugar viria a escolha do scaling, que define se a primeira camada comeca na regiao responsiva da tanh ou ja saturada. A imputacao e a menos critica das tres — com cerca de 2% de faltantes, mediana ou media deslocam a acuracia final numa fracao de ponto percentual. Vale uma ressalva contra a propria escolha feita aqui: imputar CryoSleep pela moda descarta um sinal, ja que CryoSleep ausente combinado com gasto zero e indicio razoavel de que o passageiro estava em criosono. Uma coluna indicadora de "faltante" provavelmente seria uma pequena melhora.
Results summary
| # | Item | Your value |
|---|---|---|
| 1 | Mixing rate at \(s = 0.5\) | 0.0025 |
| 2 | Mixing rate at \(s = 1.0\) | 0.0500 |
| 3 | Mixing rate at \(s = 2.0\) | 0.2025 |
| 4 | Mixing rate at \(s = 4.0\) | 0.4300 |
| 5 | Smallest \(r_{ij}\) at \(s = 1.0\), and which pair | 1.3258 — par (0, 1) |
| 6 | Distance between centers — Dataset I | 3.2282 |
| 7 | Distance between centers — Dataset II | 0.2662 |
| 8 | Explained variance PC1 + PC2 — Dataset I | 0.6597 (PC1 0.5004 + PC2 0.1593) |
| 9 | Explained variance PC1 + PC2 — Dataset II | 0.4291 (PC1 0.2159 + PC2 0.2132) |
| 10 | Share of the positive class in Transported | 0.5036 |
| 11 | Mean and median of FoodCourt on the training set, before transforming | 452.6112 e 0.0000 |
| 12 | Final shape of the training feature matrix | 6954, 17 |
| 13 | Minimum and maximum of the training and test sets after scaling | treino -1.0000, 1.0000 — teste -1.0000, 1.1383 |